Вспомните: в прошлой теме вы читали таблицу расходов из CSV и сохраняли настройки в JSON. Это текст: его можно открыть Блокнотом и прочитать глазами. Фото из «Загрузок», PDF со сканом договора, архив — не текст. Если открыть такой файл в Блокноте, вы увидите кашу из символов. Внутри там байты, и сегодня мы научимся с ними работать.
🎯 После урока сможете: открыть любой файл в двоичном режиме, перевести строку в байты и обратно, посчитать, сколько места строка займёт в UTF-8, узнать тип файла по первым байтам (даже если расширение потеряно или врёт) и скопировать большой файл кусками.
Байт и тип bytes
Байт — это число от 0 до 255. Любой файл на диске — просто длинная цепочка таких чисел. Что они значат (буквы, пиксели, звук), решает программа, которая файл открывает.
В Python для цепочки байтов есть тип bytes. Записывается как строка с буквой b впереди. Байты, которые не похожи на буквы латиницы, Python показывает в виде \x и двух шестнадцатеричных цифр.
data = b"PNG"
print(data)        # b'PNG'
print(data[0])     # 80 — код буквы P
print(len(data))   # 3

raw = bytes([72, 105, 255])
print(raw)         # b'Hi\xff'
Обратите внимание: элемент bytes по индексу — это число, а не буква. Срез data[1:3] вернёт снова bytes: b'NG'. Изменить байт в bytes нельзя, как и символ в строке. Если нужен изменяемый вариант, есть bytearray, но в этой теме он не понадобится.
Откуда там буквы? Обычные числа записывают десятью цифрами 0–9. В шестнадцатеричной записи (hex) цифр шестнадцать: после 9 идут буквы a=10, b=11, c=12, d=13, e=14, f=15. Разряды считаются так же, как в десятичной, только «десяток» здесь равен 16: 0a = 10, 0f = 15, 10 = 16, 50 = 5·16 = 80, ff = 15·16 + 15 = 255. Поэтому любой байт (0–255) — ровно две hex-цифры, от 00 до ff. В коде такое число пишут с приставкой 0x: 0x50 — это 80.
Переводить руками не обязательно, Python сделает сам. ord даёт код символа — номер буквы в таблице ASCII (латиница, цифры, знаки), hex и int(..., 16) переводят туда и обратно:
print(ord("P"))       # 80 — код буквы P
print(hex(80))         # 0x50
print(int("50", 16))   # 80
print(0xff)            # 255
Метод .hex(" ") печатает байты сразу в hex, по две цифры через пробел:
head = b"\x89PNG\r\n\x1a\n"
print(head.hex(" "))   # 89 50 4e 47 0d 0a 1a 0a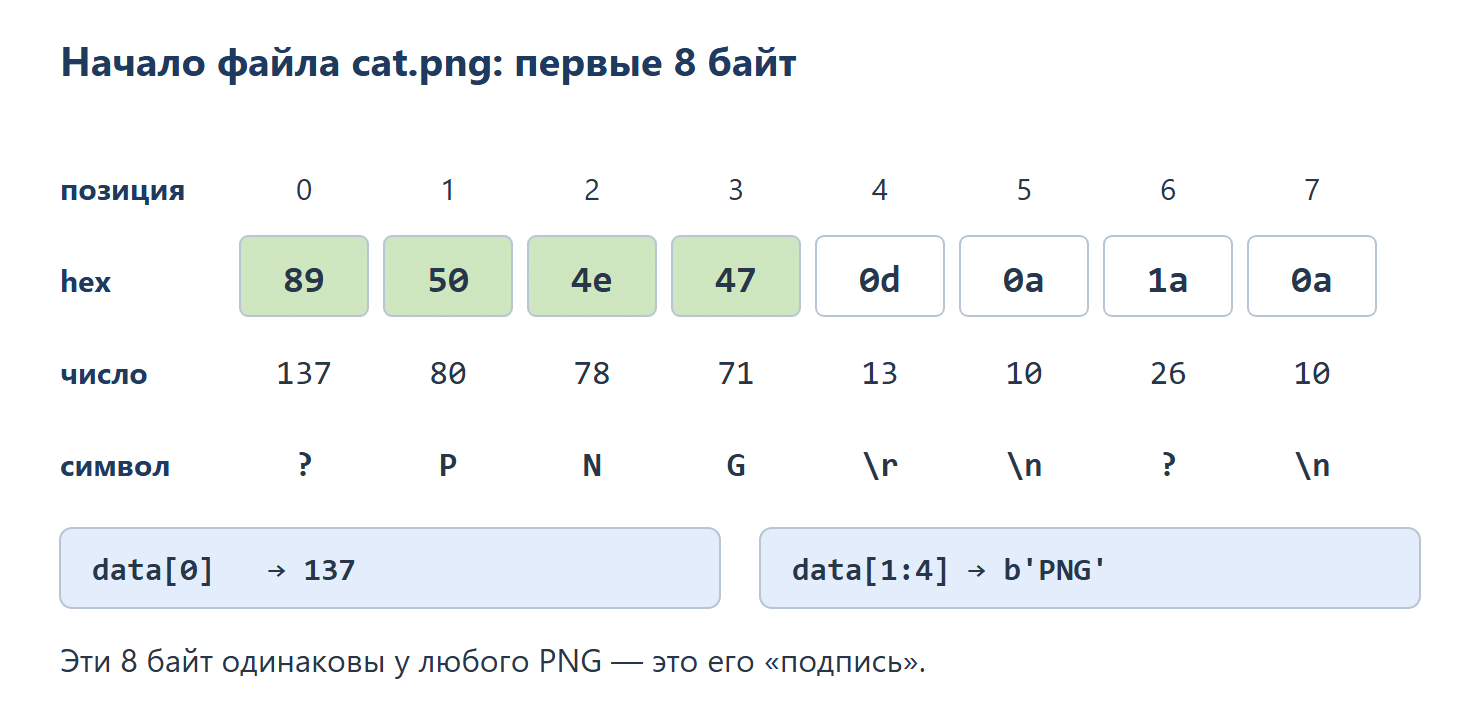
Проверьте себя
Контрольный вопрос. Что выведет код? Введите число.
Исходный код для этого задания:
data = b"PNG"
print(data[0])
Подсказка: Элемент bytes по индексу — число: код символа по таблице ASCII.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Выберите вариант.
Исходный код для этого задания:
head = b"\x89PNG" print(head[1:4])Подсказка: Срез bytes возвращает bytes, а не строку и не список. Позиции считаются с нуля.
Онлайн-проверка ответа появится позже
Режимы 'rb' и 'wb'
Чтобы получить байты файла, откройте его с буквой b в режиме: 'rb' — читать, 'wb' — записать (старое содержимое стирается). Кодировку encoding в двоичном режиме не указывают: Python ничего не переводит в текст, отдаёт байты как есть.
from pathlib import Path

photo = Path.home() / "Downloads" / "cat.png"

if photo.exists():
    with open(photo, "rb") as f:
        data = f.read()
    print(type(data))   # <class 'bytes'>
    print(len(data))    # размер файла в байтах
f.read() без числа читает весь файл. f.read(8) — только 8 байт от текущей позиции. Для чтения заголовка этого хватает, весь файл грузить в память не нужно.
В двоичный файл записывают только bytes. Строку туда передать нельзя — Python выдаст ошибку TypeError. Строку сначала переводят в байты.
with open("hello.bin", "wb") as f:
    f.write(b"Hi")          # можно
    # f.write("Привет")    # TypeError: нужен bytes, а не str
Проверьте себя
Контрольный вопрос. Вы хотите прочитать байты фотографии cat.jpg. Какая строка открывает файл правильно?
Подсказка: Для двоичного файла в режиме нужна буква b, а кодировку не указывают.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Программа падает с TypeError. Какой метод нужно вызвать у переменной text, чтобы запись сработала? Введите только имя метода, без точки и скобок.
Исходный код для этого задания:
text = "Привет"
with open("hi.bin", "wb") as f:
    f.write(text)
Подсказка: В файл, открытый в ‘wb’, пишут только bytes. Какой метод превращает строку в байты?
Онлайн-проверка ответа появится позже
Строка в байты и обратно: encode и decode
str.encode() превращает текст в байты, bytes.decode() — байты в текст. По умолчанию используется UTF-8, но лучше писать кодировку явно, как вы делали с open(..., encoding="utf-8").
text = "Я"
b = text.encode("utf-8")
print(b)              # b'\xd0\xaf'
print(list(b))        # [208, 175]
print(b.decode("utf-8"))   # Я
В UTF-8 разные символы занимают разное число байт. Латиница и цифры — 1 байт, кириллица — 2, знак евро — 3, эмодзи — 4. Поэтому len(строки) и размер той же строки в файле часто не совпадают.
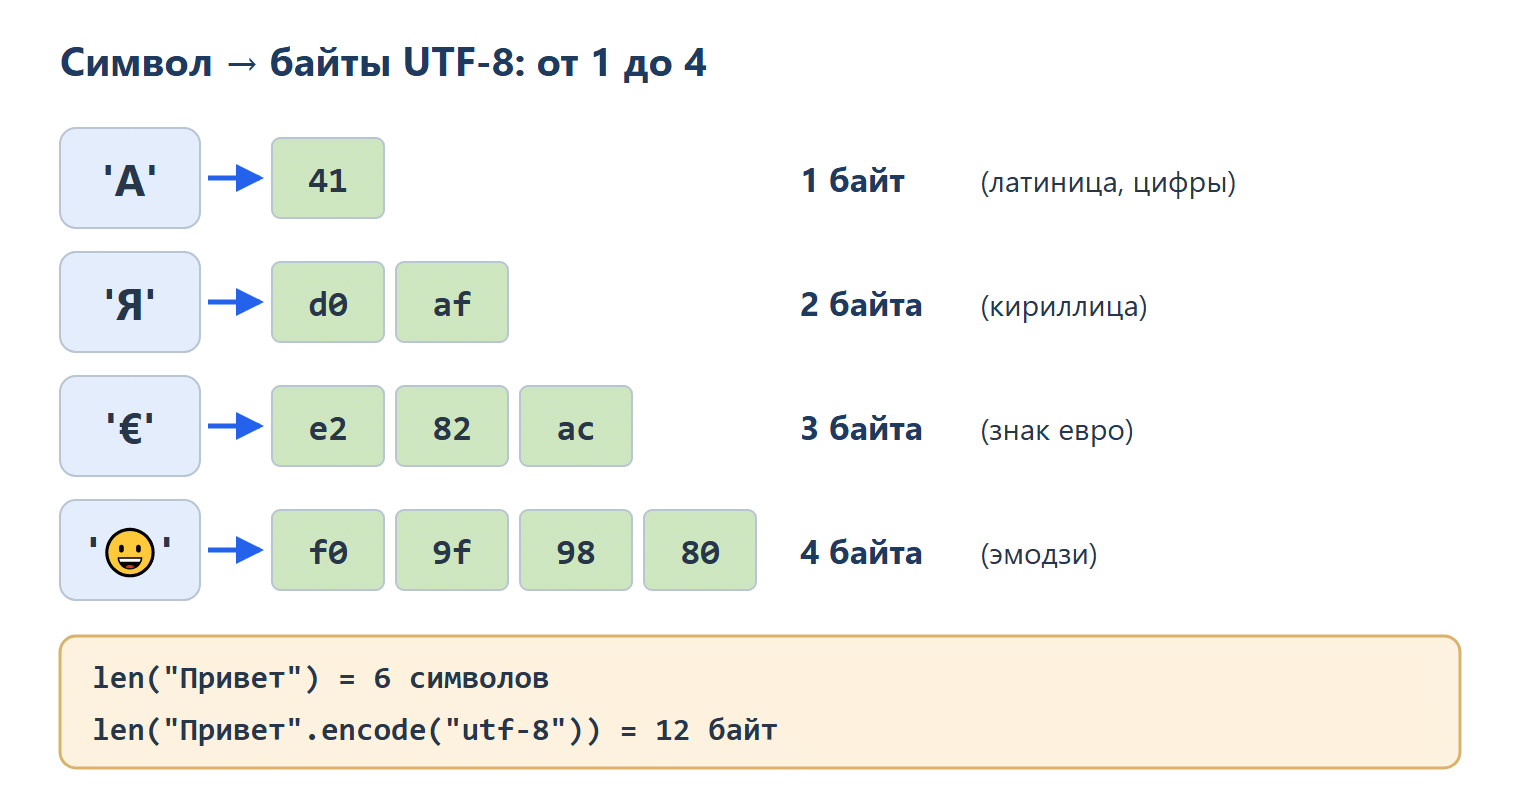
for s in ["cat", "кот", "Hi😀"]:
    print(s, len(s), len(s.encode("utf-8")))

# cat 3 3
# кот 3 6
# Hi😀 3 6
Если декодировать байты не той кодировкой, получите «кракозябры» или ошибку
UnicodeDecodeError. Так бывает с CSV, сохранённым из старого Excel вcp1251. Байты при этом целы — поменяйте кодировку вdecodeили вopen.
Проверьте себя
Контрольный вопрос. Что выведет код? Введите результат ровно как на экране.
Исходный код для этого задания:
print(bytes([72, 105]).decode("utf-8"))Подсказка: decode переводит коды обратно в символы. Код символа можно узнать у себя через ord(), а символ по коду — через chr().
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Введите число.
Исходный код для этого задания:
print(len("cat1".encode()))Подсказка: Сколько байт в UTF-8 занимает латинская буква и цифра? Посчитайте символы строки.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Сколько байт займёт строка в UTF-8? Введите число.
Исходный код для этого задания:
print(len("кот".encode("utf-8")))Подсказка: Сколько байт в UTF-8 занимает одна русская буква? Посмотрите картинку «Сколько байт» в уроке и умножьте на число букв.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Сколько байт займёт знак евро в UTF-8? Введите число.
Исходный код для этого задания:
print(len("€".encode("utf-8")))Подсказка: Сверьтесь с картинкой «Сколько байт в UTF-8» в уроке или проверьте у себя через len(…encode()).
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Введите число.
Исходный код для этого задания:
print(len("Ок😀".encode("utf-8")))Подсказка: Посчитайте байты каждого символа по правилу из урока: сколько занимает кириллица, сколько эмодзи.
Онлайн-проверка ответа появится позже
Задание. Названия трёх папок: «Ёж», «tea», «чай». Программа сохраняет их в файл через encode(«utf-8») подряд, без разделителей. Сколько байт будет в файле? Введите число.
Исходный код для этого задания:
words = ["Ёж", "tea", "чай"]
with open("names.bin", "wb") as f:
    for w in words:
        f.write(w.encode("utf-8"))
Подсказка: Посчитайте байты каждого слова: кириллица по 2, латиница по 1. Буква Ё — тоже кириллица.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Тип файла по первым байтам
Расширение — просто часть имени, его легко потерять или поменять. А вот начало файла у многих форматов фиксированное. Это называют сигнатурой (или «магическими байтами»). Прочитайте первые байты и сравните методом startswith.
- PNG:
89 50 4e 47— то естьb"\x89PNG" - JPEG:
ff d8 ff—b"\xff\xd8\xff" - PDF:
25 50 44 46—b"%PDF"
SIGNATURES = {
    b"\x89PNG": "png",
    b"\xff\xd8\xff": "jpg",
    b"%PDF": "pdf",
}


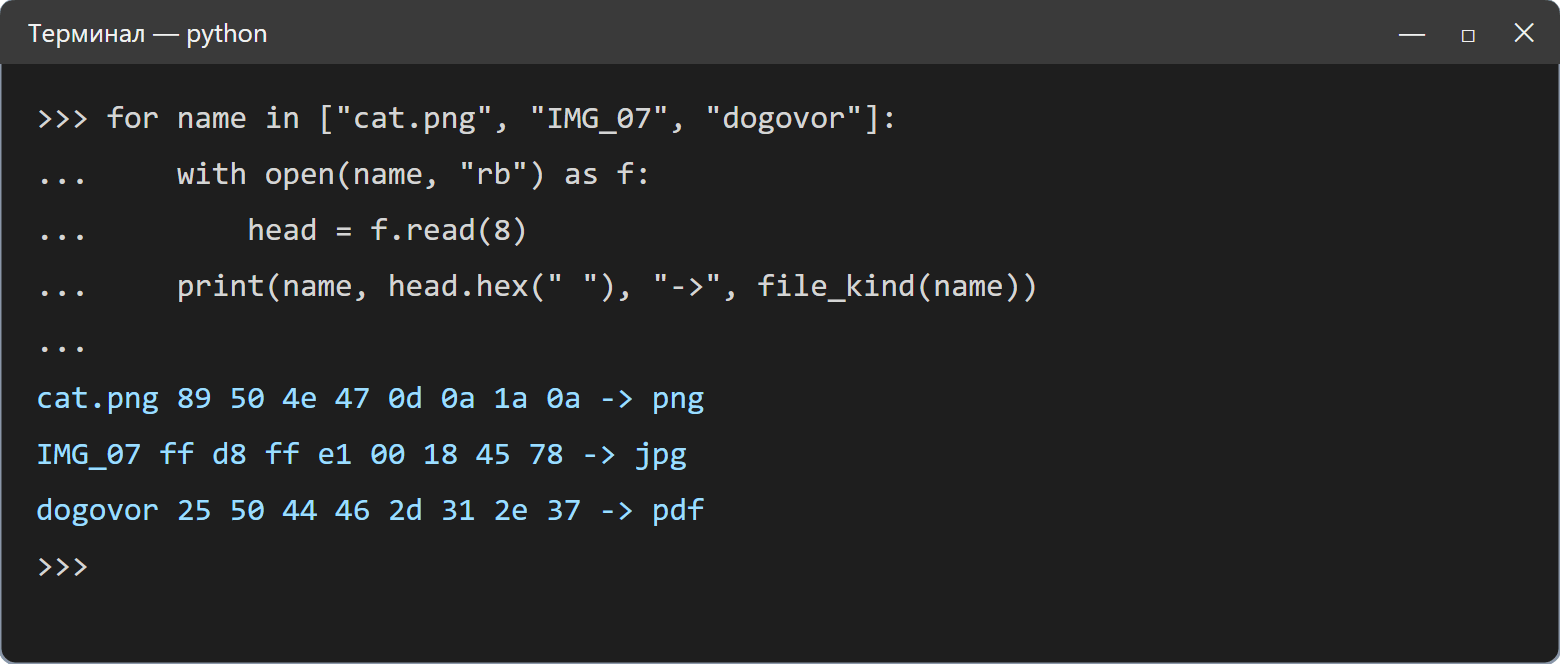
def file_kind(path):
    """Вернуть тип файла по первым байтам."""
    with open(path, "rb") as f:
        head = f.read(8)
    for sign, kind in SIGNATURES.items():
        if head.startswith(sign):
            return kind
    return "unknown"


print(file_kind("cat.png"))   # png
Заголовок картинки хранит не только сигнатуру. У PNG сразу за ней лежат размеры: байты 16–19 — ширина, 20–23 — высота. Каждое число записано четырьмя байтами, старший первым. Собрать из них обычное число помогает int.from_bytes(..., "big") ("big" — старший байт идёт первым):
from pathlib import Path

photo = Path.home() / "Downloads" / "cat.png"
if photo.exists():
    with open(photo, "rb") as f:
        head = f.read(24)
    if head.startswith(b"\x89PNG"):
        width = int.from_bytes(head[16:20], "big")
        height = int.from_bytes(head[20:24], "big")
        print(width, "x", height)   # например: 1920 x 1080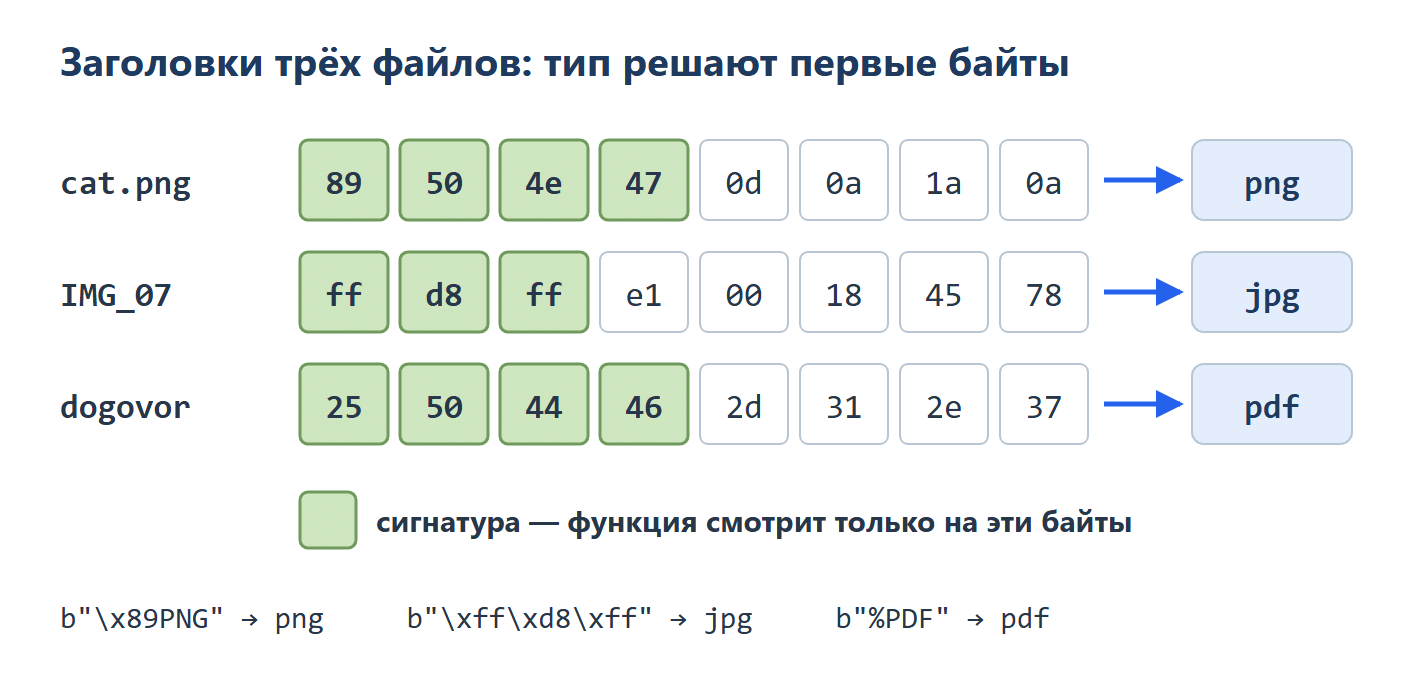
Проверьте себя
Контрольный вопрос. Первые байты файла без расширения: ff d8 ff e0. Что это за файл?
Подсказка: Сравните с сигнатурами из урока: PNG — 89 50 4e 47, JPEG — ff d8 ff, PDF — 25 50 44 46.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что подставить вместо ___, чтобы функция узнавала PDF? Выберите вариант.
Исходный код для этого задания:
def is_pdf(path): with open(path, "rb") as f: head = f.read(4) return head == ___Подсказка: f.read в режиме ‘rb’ возвращает bytes. С чем bytes может оказаться равным? Сверьте сигнатуру PDF со списком в уроке.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Введите результат ровно как на экране.
Исходный код для этого задания:
data = b"PK\x03\x04\x14\x00"
print(data[:3].hex(" "))
Подсказка: Срез [:3] — первые три байта, .hex(» «) печатает их двумя цифрами через пробел.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Программа прочитала первые 24 байта PNG-картинки. Байты с 16-го по 23-й в hex:
00 00 03 20 00 00 02 58. Какая высота картинки в пикселях? Введите число.Подсказка: Высота — вторые четыре байта (20–23). Соберите из них число методом int.from_bytes со старшим байтом первым, как в примере урока.
Онлайн-проверка ответа появится позже
Задание. Проектная миссия «Разбор Загрузок». Напишите функцию file_kind(head), которая по первым байтам возвращает «png», «jpg», «pdf» или «unknown», и программу, которая раскладывает файлы по папкам «Картинки» (png и jpg), «Документы» (pdf) и «Прочее». Для проверки ниже даны первые 8 байт 42 файлов в hex: превратите строку в bytes через bytes.fromhex(…) и передайте в file_kind. В поле ответа — сколько файлов попадёт в «Картинки». Приложите файл программы .py; в поле ответа — число.
Строки, которые начинаются с#, — пояснения к данным: в файлы их не копируйте.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. тип определяется по байтам, а не по расширению;
4. похожие, но неверные заголовки (одна цифра не та) дают «unknown».# имя — первые байты файла в hex
file_01 — 25 50 44 46 2d 31 2e 37
file_02.png — 49 44 33 04 00 00 00 00
file_03.dat — ff d8 ff e1 00 18 45 78
file_04.png — 50 44 46 2d 31 2e 37 0a
file_05 — 68 65 6c 6c 6f 20 77 6f
file_06 — ff d8 ff e0 00 10 4a 46
file_07.png — 50 44 46 2d 31 2e 37 0a
file_08.dat — ff d8 ff e0 00 10 4a 46
file_09.png — 49 44 33 04 00 00 00 00
file_10.png — 68 65 6c 6c 6f 20 77 6f
file_11.bin — 89 50 4e 58 0d 0a 1a 0a
file_12.dat — 25 50 44 46 2d 31 2e 37
file_13.pdf — ff d8 00 e0 00 10 4a 46
file_14.pdf — 25 50 44 46 2d 31 2e 37
file_15.jpg — 68 65 6c 6c 6f 20 77 6f
file_16.tmp — 49 44 33 04 00 00 00 00
file_17.txt — 25 50 44 46 2d 31 2e 37
file_18.pdf — 47 49 46 38 39 61 01 00
file_19.jpg — ff d8 ff e0 00 10 4a 46
file_20.bin — ff d8 00 e0 00 10 4a 46
file_21.bin — 49 44 33 04 00 00 00 00
file_22.jpg — ff d8 ff e0 00 10 4a 46
file_23.png — 25 50 44 46 2d 31 2e 34
file_24.pdf — ff d8 ff e1 00 18 45 78
file_25.tmp — 89 50 4e 58 0d 0a 1a 0a
file_26.txt — ff d8 ff e1 00 18 45 78
file_27.bin — 25 50 44 46 2d 31 2e 37
file_28.png — 50 44 46 2d 31 2e 37 0a
file_29.dat — 47 49 46 38 39 61 01 00
file_30.jpg — 47 49 46 38 39 61 01 00
file_31.dat — ff d8 00 e0 00 10 4a 46
file_32.txt — 50 4b 03 04 14 00 00 00
file_33.tmp — 50 4b 03 04 14 00 00 00
file_34 — 25 50 44 46 2d 31 2e 37
file_35.txt — 49 44 33 04 00 00 00 00
file_36 — 25 50 44 46 2d 31 2e 37
file_37.bin — ff d8 ff e0 00 10 4a 46
file_38.txt — 89 50 4e 47 0d 0a 1a 0a
file_39.png — ff d8 00 e0 00 10 4a 46
file_40.dat — 49 44 33 04 00 00 00 00
file_41.bin — 68 65 6c 6c 6f 20 77 6f
file_42.dat — 68 65 6c 6c 6f 20 77 6f
# На своих файлах: head = open(path, "rb").read(8)
Подсказка: Разберите каждую строку: имя и hex разделены « — ». head = bytes.fromhex(hex_часть), затем file_kind(head) и счётчик для png и jpg. Имя файла не смотрите.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Копирование файла кусками
Видео на 4 ГБ целиком в память читать не стоит. Читайте кусками фиксированного размера и сразу пишите в новый файл. Когда файл кончится, read вернёт пустые байты b"" — это сигнал выйти из цикла.
CHUNK = 64 * 1024   # 64 КБ


def copy_file(src, dst):
    """Скопировать файл кусками по CHUNK байт."""
    with open(src, "rb") as fin, open(dst, "wb") as fout:
        while True:
            piece = fin.read(CHUNK)
            if not piece:
                break
            fout.write(piece)


copy_file("video.mp4", "video_copy.mp4")
Если файл 10 000 байт, а кусок 4096, цикл запишет три куска: 4096, 4096 и 1808 байт. Четвёртый read вернёт b"". Копия совпадёт с оригиналом байт в байт — проверить можно, сравнив Path(src).stat().st_size и размер копии.
Попробуйте у себя: возьмите любую картинку из «Загрузок», переименуйте копию в
test.datи прогоните черезfile_kind. Функция всё равно скажет, что это картинка.
Проверьте себя
Задание. Файл занимает 20000 байт. Его копируют функцией ниже с CHUNK = 4096. Сколько раз выполнится fout.write? Введите число.
Исходный код для этого задания:
CHUNK = 4096
with open("a.bin", "rb") as fin, open("b.bin", "wb") as fout:
    while True:
        piece = fin.read(CHUNK)
        if not piece:
            break
        fout.write(piece)
Подсказка: Сколько полных кусков по 4096 помещается в 20000 и остаётся ли хвост? Пустой кусок не пишется.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Задание. Проектная миссия «Надёжная копия». Напишите функцию copy_file(src, dst, chunk=65536), которая копирует файл кусками, считает, сколько кусков записано, и возвращает это число; после копирования сравните размеры src и dst через Path.stat().st_size. Для проверки создайте 40 тестовых файлов с размерами из списка ниже (файл нужного размера: f.write(b»\0″ * size) в режиме «wb»), скопируйте каждый и сложите числа кусков. В поле ответа — общее число записанных кусков. Приложите файл программы .py; в поле ответа — число.
Строки, которые начинаются с#, — пояснения к данным: в файлы их не копируйте.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. файл читается в режиме ‘rb’ кусками, а не целиком;
4. цикл останавливается на пустом куске, пустой файл даёт 0 кусков;
5. размеры src и dst совпадают.# chunk = 65536 байт (64 КБ); размеры файлов в байтах
клип_01.mp4 — 1475350
клип_02.mp4 — 939472
клип_03.mp4 — 1688415
клип_04.mp4 — 327680
клип_05.mp4 — 125258
клип_06.mp4 — 90493
клип_07.mp4 — 144216
клип_08.mp4 — 175946
клип_09.mp4 — 756384
клип_10.mp4 — 2386430
клип_11.mp4 — 144588
клип_12.mp4 — 22629
клип_13.mp4 — 96785
клип_14.mp4 — 132379
клип_15.mp4 — 51647
клип_16.mp4 — 350878
клип_17.mp4 — 816549
клип_18.mp4 — 0
клип_19.mp4 — 127924
клип_20.mp4 — 1717367
клип_21.mp4 — 48330
клип_22.mp4 — 2886100
клип_23.mp4 — 414583
клип_24.mp4 — 126366
клип_25.mp4 — 91406
клип_26.mp4 — 972664
клип_27.mp4 — 141446
клип_28.mp4 — 25268
клип_29.mp4 — 107015
клип_30.mp4 — 810911
клип_31.mp4 — 1757193
клип_32.mp4 — 177851
клип_33.mp4 — 426985
клип_34.mp4 — 812611
клип_35.mp4 — 14899
клип_36.mp4 — 71490
клип_37.mp4 — 2017353
клип_38.mp4 — 334459
клип_39.mp4 — 187271
клип_40.mp4 — 100430
def copy_file(src, dst, chunk=65536):
count = 0
# ваш код: open(…, "rb"), open(…, "wb"), цикл read/write
return count
Подсказка: Счётчик увеличивайте только после fout.write(piece), то есть на непустом куске. Итог — сумма возвращённых значений по всем 40 файлам.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Что дальше
Теперь вы умеете открывать файлы в режимах 'rb' и 'wb', переводить текст в байты и обратно, считать размер строки в UTF-8, узнавать PNG, JPEG и PDF по сигнатуре и копировать большие файлы кусками. Глава «Файлы и данные» пройдена. Дальше — как сделать программы надёжными: что делать, когда файла нет или данные испорчены.
← Назад · ↑ В начало урока · ⌂ К навигатору курса · Вперёд →