Вспомните: в «Основах Python» всё, что программа знала, жило в переменных и пропадало после закрытия окна. Список покупок, сумма расходов, счётчик — перезапустили программу, и начинайте заново. Файл решает это: программа записала данные на диск, а завтра прочитала их обратно.
🎯 После урока сможете: открыть текстовый файл в Python, прочитать его целиком или построчно, записать и дописать строки и не получить кракозябры вместо русских букв.
Функция open и четыре режима
Файл открывает функция open(имя, режим, encoding=...). Она возвращает объект файла, у которого есть методы для чтения и записи. Режим — строка из одной буквы:
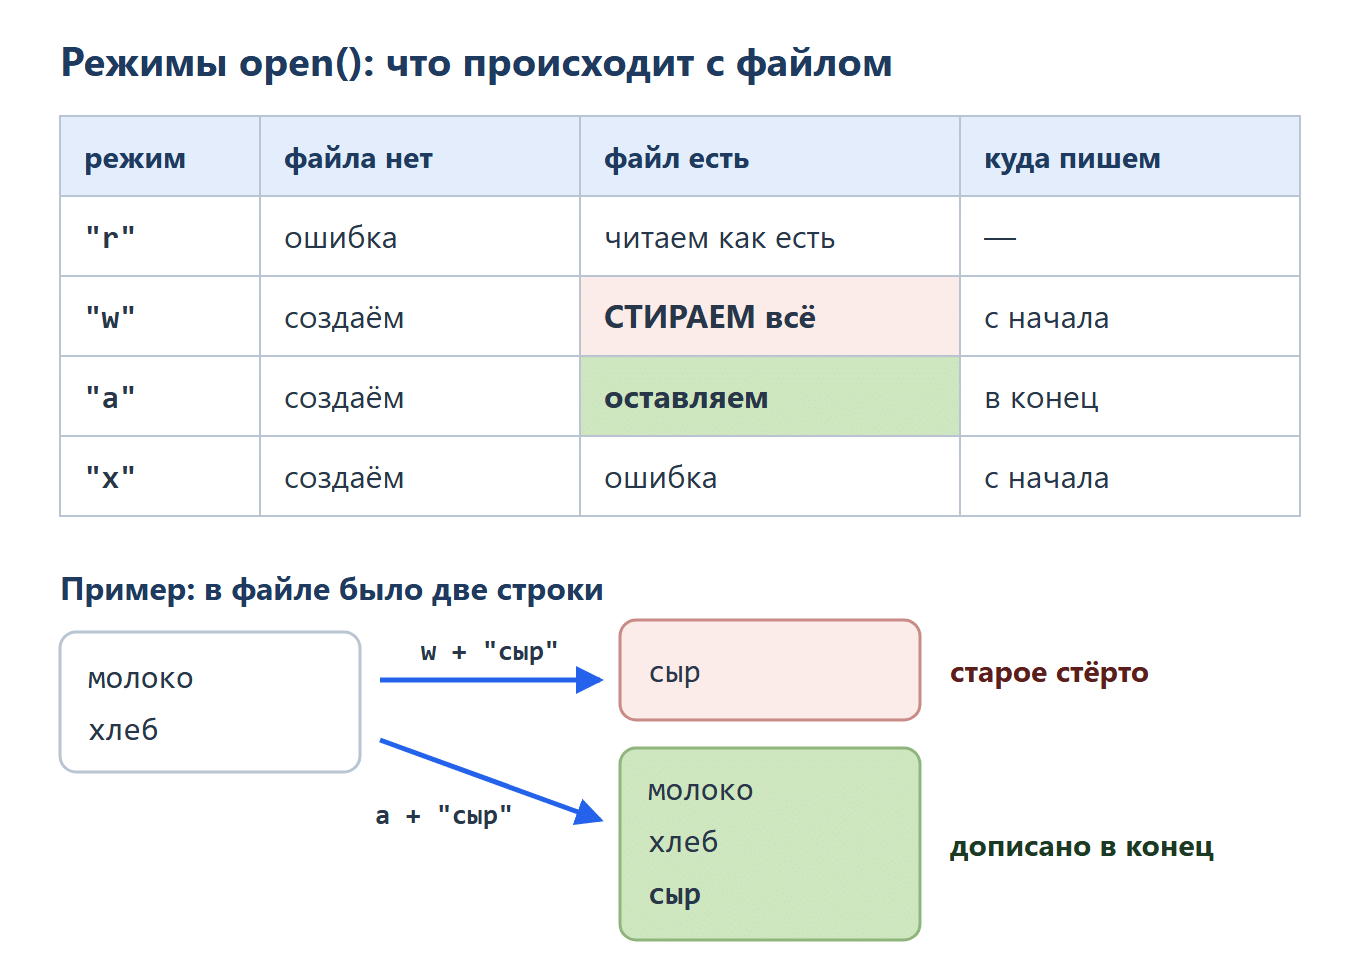
"r"— чтение (режим по умолчанию). Файла нет — ошибка."w"— запись. Файла нет — создаётся. Файл есть — его содержимое стирается."a"— дозапись в конец. Старое содержимое остаётся."x"— создать новый файл. Если такой уже есть — ошибка, ничего не затрётся.
Режим
"w"— самая частая причина потерянных данных. Хотели добавить строку в журнал, открыли на запись — и журнал стал пустым. Добавляете — берите"a".
Проверьте себя
Контрольный вопрос. Вы ведёте журнал и хотите добавить в конец файла новую строку, не стерев старые. Какой режим нужно передать в open? Выберите вариант.
Подсказка: Один режим стирает файл, другой только читает, третий падает, если файл уже есть.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Введите строку без кавычек.
Исходный код для этого задания:
with open("log.txt", "w", encoding="utf-8") as f:
    f.write("A")
with open("log.txt", "w", encoding="utf-8") as f:
    f.write("B")
with open("log.txt", encoding="utf-8") as f:
    print(f.read())
Подсказка: Режим «w» стирает всё, что было в файле.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Что выведет код? Введите строку без кавычек и пробелов.
Исходный код для этого задания:
with open("log.txt", "w", encoding="utf-8") as f:
    f.write("A")
with open("log.txt", "a", encoding="utf-8") as f:
    f.write("B")
with open("log.txt", encoding="utf-8") as f:
    print(f.read())
Подсказка: Режим «a» дописывает в конец и не трогает старое.
Онлайн-проверка ответа появится позже
with: файл закроется сам
Открытый файл нужно закрыть, иначе запись может не долететь до диска. Вместо ручного f.close() пишут блок with: как только отступ закончился, Python закрывает файл сам — даже если внутри блока что-то пошло не так.
with open("pokupki.txt", "w", encoding="utf-8") as f:
    f.write("молоко\n")
    f.write("хлеб\n")

print(f.closed)  # True — файл уже закрыт
Метод write пишет строку ровно как есть. Перевод строки \n он сам не добавляет — ставьте его явно. Метод writelines(список) пишет все строки списка подряд, тоже без переводов строк.
with open("pokupki.txt", "a", encoding="utf-8") as f:
    f.writelines(["сыр\n", "яйца\n"])
# в файле теперь 4 строки: молоко, хлеб, сыр, яйца
Проверьте себя
Контрольный вопрос. Что выведет код? Введите строку без кавычек.
Исходный код для этого задания:
with open("abc.txt", "w", encoding="utf-8") as f:
    f.writelines(["a", "b", "c"])
with open("abc.txt", encoding="utf-8") as f:
    print(f.read())
Подсказка: writelines не добавляет переводы строк сам.
Онлайн-проверка ответа появится позже
Чтение: целиком, по строке, списком, в цикле
Пусть рядом с программой лежит файл pokupki.txt:
молоко
хлеб
сыр
яйцаf.read()— весь файл одной строкой;f.readline()— следующая одна строка, вместе с\nна конце;f.readlines()— список всех строк;for line in f:— перебор строк по одной. Так читают большие файлы: в память не грузится всё сразу.
with open("pokupki.txt", encoding="utf-8") as f:
    first = f.readline()
    rest = f.readlines()

print(repr(first))  # 'молоко\n'
print(len(rest))    # 3 — чтение продолжилось со второй строки
repr() показывает строку так, как её пишут в коде: в кавычках и со служебными символами вроде \n. Обычный print перевод строки не показывает, а repr делает его видимым. Файл читается как лента: каждый вызов продолжает с того места, где остановился предыдущий. Прочитали всё через read() — повторный read() вернёт пустую строку.
with open("pokupki.txt", encoding="utf-8") as f:
    for line in f:
        print(line.strip())
# молоко
# хлеб
# сыр
# яйца
У каждой прочитанной строки на конце
\n. Безstrip()"хлеб\n" == "хлеб"окажетсяFalse.
Проверьте себя
Контрольный вопрос. В файле notes.txt три строки: «молоко», «хлеб», «сыр» (каждая заканчивается переводом строки). Что выведет код? Введите число.
Исходный код для этого задания:
with open("notes.txt", encoding="utf-8") as f:
    lines = f.readlines()
print(len(lines))
Подсказка: readlines возвращает список строк.
Онлайн-проверка ответа появится позже
Контрольный вопрос. В файле plan.txt три строки: «купить хлеб», «позвонить маме», «оплатить связь». Код ниже печатает одну из них. Какая по счёту строка файла будет напечатана? Введите её порядковый номер числом, а не текст строки.
Исходный код для этого задания:
with open("plan.txt", encoding="utf-8") as f:
    f.readline()
    print(f.readline().strip())
Подсказка: Каждый readline продолжает с того места, где остановился предыдущий.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Код должен печатать строки файла без лишних пустых строк между ними. Какое имя метода строки нужно вписать вместо ___? Введите только имя метода, без точки и скобок.
Исходный код для этого задания:
with open("pokupki.txt", encoding="utf-8") as f:
    for line in f:
        print(line.___())
Подсказка: Метод убирает пробельные символы, включая \n, по краям строки.
Онлайн-проверка ответа появится позже
Задание. В файле text.txt четыре строки:
раз два
три
(пустая строка)
четыре пять шестьНапишите программу, которая читает файл построчно в цикле for и считает общее количество слов (слова разделены пробелами). Введите число, которое получится.
Приём: построчное чтение + split(). Файл создайте сами с содержимым из условия.
Подсказка: len(line.split()) для пустой строки даёт 0.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Задание. В файле nums.txt по одному числу в строке, одна строка пустая:
10
25
(пустая строка)
5Напишите программу, которая читает файл построчно, пропускает пустые строки и печатает сумму чисел. Введите сумму.
Приём: for line in f, проверка line.strip(), int(). Пустая строка в int() даст ошибку — её надо пропустить.
Подсказка: if line.strip(): — истинно только для непустой строки.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Кодировки: откуда берутся кракозябры
На диске хранятся байты, а не буквы. Кодировка — правило, по которому буквы превращаются в байты и обратно. Латиница одинакова почти везде, а русские буквы в разных кодировках записаны разными байтами. В UTF-8 каждая русская буква занимает 2 байта, в старой виндовой cp1251 — 1 байт.
print("Привет".encode("utf-8"))   # b'\xd0\x9f\xd1\x80...' — 12 байт
print("Привет".encode("cp1251"))  # b'\xcf\xf0\xe8\xe2\xe5\xf2' — 6 байт
Если файл записан в UTF-8, а прочитан как cp1251, каждая пара байтов превратится в две чужие буквы — это и есть кракозябры вида «РџСЂРёРІРµС‚». Без параметра encoding Python до версии 3.14 включительно берёт кодировку системы: на macOS и Linux это UTF-8, на Windows часто cp1251. Поэтому одна и та же программа у вас работает, а у коллеги показывает мусор. С Python 3.15 кодировкой по умолчанию стала UTF-8 на всех системах (предложение PEP 686). Но у многих ещё стоят старые версии, а режим можно отключить настройкой, поэтому encoding="utf-8" всё равно пишем явно — так советует и документация Python.
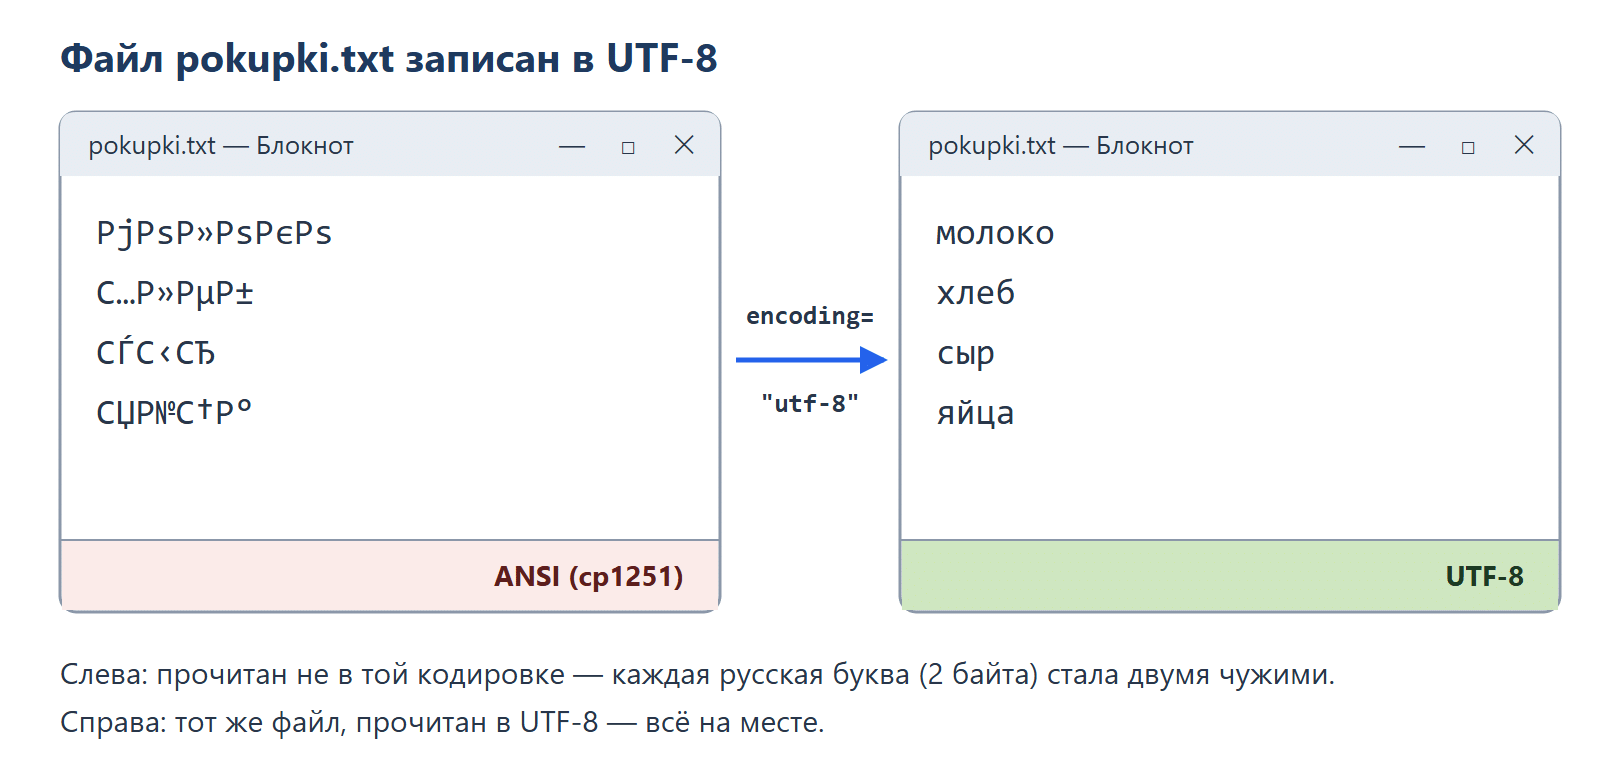
Правило простое: всегда указывайте encoding="utf-8" и при чтении, и при записи. Если чужой файл (например, выгрузка из старой программы) всё равно читается мусором — откройте его с encoding="cp1251" и перезапишите в UTF-8:
with open("staryj.txt", encoding="cp1251") as f:
    text = f.read()
with open("novyj.txt", "w", encoding="utf-8") as f:
    f.write(text)
Запустите у себя: создайте
pokupki.txtиз примера выше, прочитайте его четырьмя способами, а потом откройте сencoding="cp1251"— увидите кракозябры своими глазами.
Проверьте себя
Контрольный вопрос. Программа записала файл в UTF-8. У коллеги на Windows этот код печатает кракозябры вместо русских слов. Какой именованный параметр нужно добавить в вызов open, чтобы это исправить? Введите только имя параметра.
Исходный код для этого задания:
with open("pokupki.txt") as f:
    print(f.read())
Подсказка: Параметр задаёт правило перевода байтов в буквы.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Сколько байт займёт слово «Привет» в файле, записанном в кодировке UTF-8 (без перевода строки)? Введите число.
Подсказка: Вспомните из раздела про кодировки, сколько байт в UTF-8 занимает одна русская буква, и умножьте на число букв. Проверить можно у себя через len(….encode(«utf-8»)).
Онлайн-проверка ответа появится позже
Задание. Миссия «Журнал расходов». Файл expenses.txt, строки в формате дата;категория;сумма — содержимое целиком в блоке ниже (50 строк, две из них пустые). Скопируйте его в файл.
Напишите утилиту: она читает файл построчно в UTF-8, разбивает строку по «;», складывает суммы и записывает в новый файл report.txt строку «Итого: N». Приложите файл программы .py; в поле ответа — число.
Строки, которые начинаются с#, — пояснения к данным: в файлы их не копируйте.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. файл открыт через with и с encoding=»utf-8″;
4. чтение построчное (for line in f), пустые строки не ломают программу;
5. в report.txt ровно одна строка «Итого: N».# expenses.txt
2026-09-29;такси;526
2026-09-01;аптека;2230
2026-09-26;кино;261
2026-09-08;аптека;1893
2026-09-30;связь;731
2026-09-20;связь;2037
2026-09-12;обед;617
2026-09-30;связь;2089
2026-09-12;аптека;1549
2026-09-06;такси;476
2026-09-19;такси;1566
2026-09-11;такси;1912
2026-09-10;обед;1137
2026-09-05;связь;706
2026-09-18;такси;1168
2026-09-07;кофе;170
2026-09-22;кино;939
2026-09-04;кино;1470
2026-09-19;кино;2344
2026-09-02;обед;458
2026-09-16;продукты;1235
2026-09-26;связь;2249
2026-09-16;продукты;1431
2026-09-10;такси;2218
2026-09-21;аптека;1710
2026-09-09;такси;900
2026-09-09;обед;1397
2026-09-02;кофе;137
2026-09-28;кофе;1463
2026-09-04;кино;2057
2026-09-27;продукты;1924
2026-09-05;кино;2214
2026-09-01;кофе;826
2026-09-11;аптека;1923
2026-09-02;продукты;1336
2026-09-03;аптека;1002
2026-09-30;кино;1844
2026-09-07;такси;1956
2026-09-20;обед;110
2026-09-06;такси;871
2026-09-04;такси;1753
2026-09-13;кино;1031
2026-09-07;кофе;1545
2026-09-13;кино;740
2026-09-08;продукты;1089
2026-09-21;аптека;1112
2026-09-04;продукты;242
2026-09-22;кино;115
Подсказка: Для каждой непустой строки: strip(), split(«;»), третья ячейка через int() — прибавить к сумме. Пустую строку пропустите проверкой if line.strip().
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Задание. Миссия «Чистый список покупок». Файл shopping.txt — содержимое целиком в блоке ниже (55 строк: разный регистр, пробелы по краям, повторы, пустые строки). Скопируйте его в файл.
Напишите утилиту: читает файл, убирает пробелы по краям, приводит к нижнему регистру, пропускает пустые строки и дубли (порядок первого появления сохраняется) и записывает результат в clean.txt — по одному товару в строке. Приложите файл программы .py; в поле ответа — сколько строк получилось в clean.txt (число).
Строки, которые начинаются с#, — пояснения к данным: в файлы их не копируйте.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. оба файла открыты через with с encoding=»utf-8″; clean.txt — в режиме «w»;
4. сравнение идёт после strip() и lower(), пустые строки не попадают в результат.# shopping.txt
ГРЕЧКА
творог
Бананы
СОЛЬ
ЛУК
яйца
ЯБЛОКИ
СЫР
СОЛЬ
ЛУК
Масло
КЕФИР
ТВОРОГ
Масло
Чай
СЫР
лук
СЫР
СЫР
Бананы
Макароны
КОФЕ
гречка
Молоко
ХЛЕБ
яйца
ГРЕЧКА
лук
ТВОРОГ
Сыр
Сахар
Бананы
Масло
Бананы
Яблоки
Гречка
Яйца
КЕФИР
Рис
чай
соль
рис
ЯБЛОКИ
бананы
ЛУК
САХАР
макароны
САХАР
САХАР
яйца
Бананы
Хлеб
Подсказка: Храните уже встреченные товары в списке seen и перед добавлением проверяйте «if x not in seen». Ответ — длина seen после обхода файла.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Что дальше
Теперь вы умеете открывать файлы через with, выбирать режим r, w или a, читать файл целиком и построчно и не ловить кракозябры благодаря encoding="utf-8". В следующем уроке выйдем на уровень выше: будем работать не с одним файлом, а с папками — наведём порядок в «Загрузках» с помощью pathlib.
← Назад · ↑ В начало урока · ⌂ К навигатору курса · Вперёд →