requests.get(адрес, params=..., headers=..., timeout=10), проверяете ответ через raise_for_status() и превращаете его в словари и списки Python методом .json(). Дальше с данными работают как с обычными структурами Python. API отдаёт уже готовые данные без вёрстки, поэтому это быстрее и надёжнее, чем парсить HTML-страницу. Нужный API бывает открытым и документированным, а бывает «внутренним» — тем, которым пользуется сам сайт. Его можно найти во вкладке «Сеть» инструментов разработчика браузера.
Ниже — всё по порядку: что такое API, первый запрос, параметры, коды ответов, постраничная выдача, ключи и лимиты и поиск API, спрятанного за страницей. Все примеры запущены, вывод в статье настоящий.
Содержание
Что такое API простыми словами
Представьте окно выдачи в столовой. Вы не заходите на кухню и не роетесь в кастрюлях. Вы говорите в окошко «суп и котлету», и вам выдают поднос. Как там готовят, вас не касается. Такое окошко между программами называется API (Application Programming Interface — интерфейс для общения программ). Когда вы парсите HTML, вы как раз «ходите на кухню»: скачиваете целую страницу с меню, рекламой и стилями и выковыриваете из неё пару цифр. Через API вы получаете только цифры, в аккуратной упаковке. Чаще всего эта упаковка — JSON (текстовый формат вида{"ключ": "значение"}, очень похожий на словарь Python).
Большинство API в вебе работают по HTTP — тому же протоколу, что и сайты. У запроса есть метод:
- GET — получить данные. С ним вы будете работать в 90% случаев.
- POST — отправить новые данные (создать запись, отправить форму).
- PUT / PATCH — изменить существующую запись.
- DELETE — удалить запись.
/repos/python/cpython — репозиторий, /repos/python/cpython/issues — его задачи. GraphQL — один адрес, на который вы шлёте запрос с перечнем нужных полей. Для старта хватит REST.
Первый запрос: requests.get и .json()
Возьмём открытый API GitHub. Ключ для него не нужен, а данные понятные: адресhttps://api.github.com/repos/python/cpython возвращает сведения о репозитории самого Python.
import requests

HEADERS = {
    "User-Agent": "learning-script/1.0",
    "Accept": "application/vnd.github+json",
}

r = requests.get("https://api.github.com/repos/python/cpython", headers=HEADERS, timeout=10)
r.raise_for_status()           # если ошибка, сразу исключение
data = r.json()                # JSON -> словарь Python

print(data["full_name"], "| звёзд:", data["stargazers_count"], "| язык:", data["language"])
print("Осталось запросов:", r.headers.get("X-RateLimit-Remaining"), "из", r.headers.get("X-RateLimit-Limit"))
python/cpython | звёзд: 77478 | язык: Python
Осталось запросов: 56 из 60
headers— заголовки запроса. User-Agent подписывает вашу программу, аAcceptговорит, какой формат вы ждёте. Пишите заголовки латиницей: русские буквы в заголовке requests не отправит.timeout=10— сколько секунд ждать ответа. Без него скрипт может висеть бесконечно, если сервер задумался.raise_for_status()— проверка кода ответа. Если сервер вернул ошибку, вы узнаете об этом сразу, а не через три строки, когда упадётdata["full_name"]..json()— превращает текст ответа в словарь или список. Внутри будут строки, числа,True/FalseиNone— обычные типы Python.
Параметры запроса: params
Фильтры, сортировку и размер страницы API обычно принимают в адресе после знака?. Склеивать такую строку руками неудобно и легко ошибиться с кодировкой. Передайте словарь в params, requests соберёт адрес сам.
Запросим три открытые задачи CPython с меткой «docs»:
r = requests.get(
    "https://api.github.com/repos/python/cpython/issues",
    params={"state": "open", "labels": "docs", "per_page": 3},
    headers=HEADERS,
    timeout=10,
)
print(r.url)
for issue in r.json():
    print(issue["number"], issue["title"][:60])
https://api.github.com/repos/python/cpython/issues?state=open&labels=docs&per_page=3
158800 gh-158797: Document the test.support.import_helper helpers
158799 gh-158798: Use "hashed collections" consistently in object._
158798 "hashable collections" in the `object.__hash__` documentatio
r.url показывает, какой адрес получился на самом деле. Если API возвращает не то, что вы ждали, первым делом смотрите туда.
Как достать нужное из вложенного JSON
Ответ API похож на матрёшку: словарь, внутри словарь, внутри список словарей. Ответ про репозиторий CPython — словарь из 86 ключей, и часть из них вложенные. Добираются до нужного цепочкой квадратных скобок. А там, где поля может не быть или в нём лежитnull (в Python — None), помогает .get() со значением по умолчанию.
data = requests.get("https://api.github.com/repos/python/cpython", headers=HEADERS, timeout=10).json()

print(data["owner"]["login"], data["owner"]["type"])           # словарь в словаре
print((data.get("license") or {}).get("name", "нет лицензии"))  # поле может быть null
print(data.get("homepage") or "сайт не указан")
print(type(data), len(data))
python Organization
Other
https://www.python.org
<class 'dict'> 86
(data.get("license") or {}) выглядит странно, но спасает от частой ошибки. Если лицензии нет, API пришлёт "license": null, и обычный data["license"]["name"] упадёт с TypeError. А так вы получите запасной текст.
Чтобы понять, как устроен незнакомый ответ, не гадайте. Распечатайте его красиво: print(json.dumps(data, indent=2, ensure_ascii=False)[:2000]). Срез [:2000] нужен, чтобы не утонуть в длинном ответе. Ещё удобнее открыть адрес API прямо в браузере: Firefox и Chrome показывают JSON деревом, которое можно сворачивать.
Коды ответов: как понять, что пошло не так
Каждый ответ сервера несёт трёхзначный код. Его стоит проверять до того, как читать данные.- 200 OK — всё хорошо, данные в теле ответа.
- 400 Bad Request — вы прислали кривые параметры.
- 401 Unauthorized / 403 Forbidden — нет ключа, ключ неверный или прав не хватает.
- 404 Not Found — такого адреса или объекта нет.
- 429 Too Many Requests — вы спрашиваете слишком часто, сбавьте темп.
- 5xx — сломалось на стороне сервера. Можно повторить позже.
for url in ("https://api.github.com/repos/python/cpython",
            "https://api.github.com/repos/python/no-such-repo-xyz"):
    r = requests.get(url, headers=HEADERS, timeout=10)
    print(r.status_code, r.reason)

try:
    requests.get("https://httpbin.org/status/429", timeout=10).raise_for_status()
except requests.HTTPError as e:
    print("Ошибка:", e)
200 OK
404 Not Found
Ошибка: 429 Client Error: TOO MANY REQUESTS for url: https://httpbin.org/status/429
Retry-After) и повторить.
Постраничная выдача (пагинация)
API почти никогда не отдаёт тысячу записей разом. Он режет их на страницы (пагинация — деление выдачи на страницы) и подсказывает, где следующая. Способы подсказки бывают разные: номер страницы в параметреpage, поле next в JSON или заголовок Link, как у GitHub. requests разбирает заголовок Link сам и кладёт результат в r.links.
Соберём первые три страницы участников CPython по пять человек:
import time

url = "https://api.github.com/repos/python/cpython/contributors"
params = {"per_page": 5}
pages, names = 0, []

while url and pages < 3:
    r = requests.get(url, params=params, headers=HEADERS, timeout=10)
    r.raise_for_status()
    names += [u["login"] for u in r.json()]
    url = r.links.get("next", {}).get("url")  # адрес следующей страницы или None
    params = None       # в адресе next параметры уже есть
    pages += 1
    time.sleep(1)       # пауза между запросами

print("Страниц:", pages, "| людей:", len(names))
print(names[:5])
Страниц: 3 | людей: 15
['gvanrossum', 'vstinner', 'benjaminp', 'serhiy-storchaka', 'birkenfeld']
pages < 3 здесь для примера. В рабочем скрипте цикл идёт, пока есть next. Но держите в голове лимиты: у участников CPython сотни страниц, а у вас без ключа — 60 запросов в час.
Ключи доступа и лимиты
Открытый API — как бесплатная библиотека: заходи кто хочешь, но книг на руки дают немного. Чтобы получить больше, нужен читательский билет. В мире API это ключ или токен (длинная строка, по которой сервер узнаёт, кто к нему пришёл). Ключ получают в личном кабинете сервиса, а передают обычно одним из двух способов:- в заголовке:
headers={"Authorization": "Bearer <токен>"}— самый частый вариант; - в параметре:
params={"apikey": "<ключ>"}— так устроены многие старые API.
.env, который внесён в .gitignore:
import os
import requests

token = os.environ["GITHUB_TOKEN"]
headers = {**HEADERS, "Authorization": f"Bearer {token}"}
r = requests.get("https://api.github.com/rate_limit", headers=headers, timeout=10)
print(r.json()["rate"])
X-RateLimit-Remaining в первом примере. Следите за ним и ставьте паузы, а на код 429 отвечайте ожиданием, а не новым залпом запросов.
API, которым пользуется сам сайт
У многих сайтов нет публичного API, зато есть внутренний. Страница приходит в браузер почти пустой, а данные подтягивает JavaScript отдельными запросами — чаще всего в том же JSON. Если найти такой запрос, можно забирать данные напрямую: без браузера, без разбора HTML и в разы быстрее. Искать его удобно в инструментах разработчика браузера:- Откройте страницу, нажмите F12 и перейдите на вкладку «Сеть» (Network).
- Включите фильтр Fetch/XHR — останутся только запросы, которые делает скрипт страницы, без картинок и стилей.
- Обновите страницу или сделайте то, что подгружает данные: прокрутите вниз, нажмите «Показать ещё», смените фильтр.
- Кликайте по появившимся строкам и смотрите вкладку «Ответ» (Response). Ищите тот, где лежат нужные вам данные.
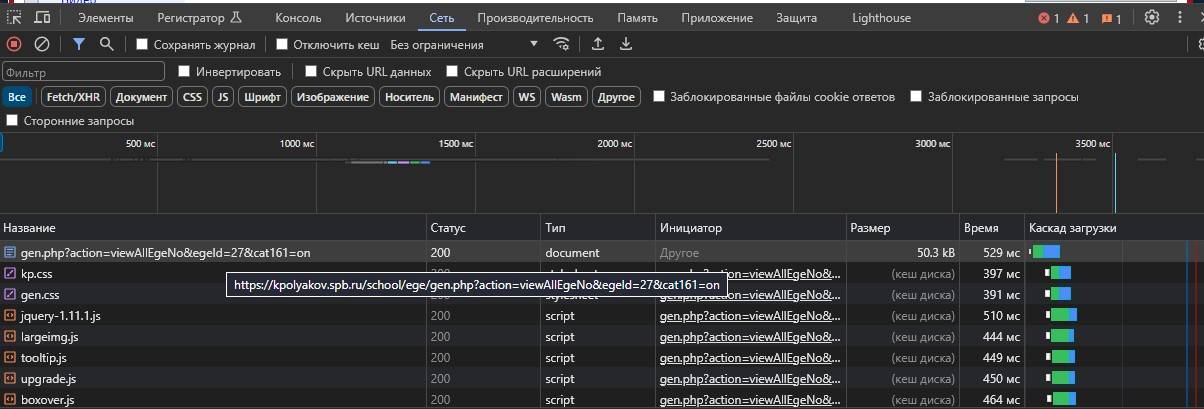
Вкладку «Сеть» открывайте до загрузки страницы. Пока она закрыта, браузер запросы не записывает, и список будет пустым.Потренируемся на учебном сайте. На странице
https://quotes.toscrape.com/scroll цитаты подгружаются при прокрутке. Если открыть вкладку «Сеть» и прокрутить вниз, появятся запросы вида /api/quotes?page=2. В HTML этих цитат нет, их приносит JavaScript. Повторим этот запрос из Python:
r = requests.get("https://quotes.toscrape.com/api/quotes", params={"page": 1}, timeout=10)
r.raise_for_status()
d = r.json()

print(d.keys())
print("Страница:", d["page"], "| есть следующая:", d["has_next"], "| цитат:", len(d["quotes"]))
q = d["quotes"][0]
print(q["author"]["name"], "-", q["text"][:50])
dict_keys(['has_next', 'page', 'quotes', 'tag', 'top_ten_tags'])
Страница: 1 | есть следующая: True | цитат: 10
Albert Einstein - “The world as we have created it is a process of o
has_next подсказывает, когда остановиться: увеличивайте page, пока оно не станет False. Это та же пагинация, только в другом виде.
Как понять, что запрос — тот самый
Сетевых запросов на большой странице бывают сотни. Несколько примет, по которым внутренний API находится быстрее:- в адресе есть
api,graphql,ajax,jsonили номер версии вроде/v2/; - тип ответа (колонка Type) —
fetchилиxhr, а заголовокContent-Type—application/json; - в адресе видны те же параметры, что вы меняете на странице: номер страницы, поисковое слово, фильтр.
requests.get и по одному убирайте лишние заголовки, пока запрос не перестанет работать. Останется минимальный рабочий набор.
Записывайте, что нашли
У внутреннего API нет документации, поэтому составьте её сами, хотя бы коротко: адрес, метод, какие параметры принимает, какие обязательны, что возвращает, есть ли пагинация и как устроена. Через месяц вы этого не вспомните. А сайт может поменять формат без предупреждения: внутренний API никто не обещал сохранять. Поэтому проверяйте в коде наличие ключей (d.get("quotes", [])) и пишите в лог, если структура ответа изменилась.
Отправка данных: POST и json=
Чтобы что-то создать через API (заявку, комментарий, запись в таблице), используют POST. Данные в формате JSON передают параметромjson=: requests сам превратит словарь в текст и поставит заголовок Content-Type: application/json. Проверим на httpbin.org — адрес /post возвращает обратно всё, что получил.
r = requests.post("https://httpbin.org/post", json={"name": "Анна", "course": "python"}, timeout=10)
r.raise_for_status()
body = r.json()
print(body["json"])
print(body["headers"]["Content-Type"])
{'course': 'python', 'name': 'Анна'}
application/json
json= и data=. Второй отправляет данные как обычная HTML-форма. Если API ждёт JSON, а вы прислали форму, ответом будет 400 или 415.
Надёжный клиент: сессия и повторы
Когда запросов много, удобно завести одну сессию (requests.Session). Она держит соединение открытым, поэтому работает быстрее, и хранит общие заголовки. К сессии можно подключить автоматические повторы: если сервер ответил 429 или 5xx, запрос повторится через паузу, которая с каждой попыткой растёт.
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

session = requests.Session()
session.headers["User-Agent"] = "learning-script/1.0"

retry = Retry(
    total=3,                                  # не больше трёх повторов
    backoff_factor=1,                         # паузы 1, 2, 4 секунды
    status_forcelist=[429, 500, 502, 503, 504],
    respect_retry_after_header=True,          # слушаемся Retry-After
)
session.mount("https://", HTTPAdapter(max_retries=retry))

r = session.get("https://httpbin.org/get", params={"q": "test"}, timeout=10)
print(r.status_code, r.json()["args"])
200 {'q': 'test'}
.json() падает. Проверяйте заголовок Content-Type или ловите исключение:
r = session.get("https://httpbin.org/html", timeout=10)
print(r.headers["Content-Type"])
try:
    r.json()
except requests.JSONDecodeError as e:
    print("Не JSON:", type(e).__name__)
text/html; charset=utf-8
Не JSON: JSONDecodeError
API плюс страницы: собираем данные из двух источников
API редко отдаёт всё, что нужно. Типичная ситуация: список объектов приходит через API, а подробности есть только на HTML-странице каждого объекта. Тогда соединяют оба способа. На quotes.toscrape.com API цитат знает автора, но не знает, когда и где он родился. Эти сведения лежат на странице автора. Возьмём авторов из API, по полюslug (короткое имя для адреса) откроем их страницы, достанем дату и место рождения и сохраним всё в CSV-таблицу:
import csv
import time
from bs4 import BeautifulSoup

BASE = "https://quotes.toscrape.com"
d = session.get(f"{BASE}/api/quotes", params={"page": 1}, timeout=10).json()

slugs = {}
for q in d["quotes"]:
    slugs.setdefault(q["author"]["name"], q["author"]["slug"])

rows = []
for name, slug in list(slugs.items())[:3]:
    page = session.get(f"{BASE}/author/{slug}/", timeout=10)
    page.raise_for_status()
    soup = BeautifulSoup(page.text, "html.parser")
    rows.append({
        "author": name,
        "born": soup.select_one(".author-born-date").get_text(strip=True),
        "place": soup.select_one(".author-born-location").get_text(strip=True),
    })
    time.sleep(1)

for row in rows:
    print(row)

with open("authors.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["author", "born", "place"])
    writer.writeheader()
    writer.writerows(rows)
{'author': 'Albert Einstein', 'born': 'March 14, 1879', 'place': 'in Ulm, Germany'}
{'author': 'J.K. Rowling', 'born': 'July 31, 1965', 'place': 'in Yate, South Gloucestershire, England, The United Kingdom'}
{'author': 'Jane Austen', 'born': 'December 16, 1775', 'place': 'in Steventon Rectory, Hampshire, The United Kingdom'}
slugs убирает повторы: у Эйнштейна на первой странице несколько цитат, а его страницу нужно открыть один раз. Каждый лишний запрос — это нагрузка на чужой сервер и шаг к лимиту.
Из JSON в таблицу: pandas
Список однотипных записей из API так и просится в таблицу. В pandas для этого естьjson_normalize: он разворачивает вложенные словари в столбцы с точкой в названии (user.login, user.type). Возьмём три последние закрытые задачи CPython:
import pandas as pd

issues = requests.get(
    "https://api.github.com/repos/python/cpython/issues",
    params={"per_page": 3, "state": "closed"},
    headers=HEADERS,
    timeout=10,
).json()

df = pd.json_normalize(issues)[["number", "comments", "created_at"]]
print(df.to_string(index=False))
 number  comments           created_at
 158792         3 2026-10-04T10:04:43Z
 158786         2 2026-10-04T01:34:36Z
 158785         1 2026-10-04T01:08:25Z
df.to_excel("issues.xlsx") для коллег, которые не пишут код.
А если не requests: httpx
У requests есть младший родственник — библиотека httpx. Почти тот же синтаксис, но умеет асинхронные запросы (когда программа не ждёт каждый ответ по очереди, а отправляет много запросов сразу). Для одного-двух запросов разницы нет. Когда запросов тысячи, httpx сasync заметно быстрее.
import httpx

with httpx.Client(headers={"User-Agent": "learning-script/1.0"}, timeout=10) as client:
    r = client.get("https://httpbin.org/get", params={"lib": "httpx"})
    r.raise_for_status()
    print(r.json()["args"])
{'lib': 'httpx'}
Как читать документацию API
Документация у разных сервисов выглядит по-разному, но ищете вы в ней одно и то же. Вот короткий список вопросов, на которые нужно найти ответ до первой строки кода:- Базовый адрес — с чего начинаются все запросы (
https://api.github.com). - Нужен ли ключ и куда его класть: в заголовок или в параметр.
- Лимиты — сколько запросов в секунду, час или сутки, и что будет при превышении.
- Пагинация — как устроены страницы и сколько записей можно взять за раз (
per_page,limit). - Формат дат и чисел — время в UTC или местное, деньги в рублях или в копейках.
- Версия API — если она есть в адресе (
/v1/), старую могут однажды выключить.
API или парсинг HTML: что выбрать
Если у сайта есть открытый API, берите его. Данные чище, формат стабильнее, а правила использования прописаны в документации. Парсить HTML стоит, когда API нет вовсе, а внутренний найти не удалось. Часто выгоднее смешанный путь: список объектов взять через API, а недостающие подробности добрать со страниц. Или наоборот, как с цитатами выше: страница — витрина, а данные приходят отдельным запросом. Если сайт целиком собран на JavaScript и внутренние запросы зашифрованы или подписаны, остаётся управлять браузером. Об этом — в материале про Selenium и Playwright.Частые ошибки при работе с API
- Нет
timeout. Скрипт работает неделю, а однажды ночью зависает навсегда на одном запросе. Ставьте таймаут в каждый вызов. - Данные читают, не проверив код ответа. Ошибка 404 тоже приходит с JSON, только внутри не данные, а
{"message": "Not Found"}. Потом KeyError в неожиданном месте. Сначалаraise_for_status(), потом разбор. - Ключ в коде. Его находят в открытом репозитории за минуты, и лимиты вашего аккаунта тратит кто-то другой. Только переменные окружения.
- Запросы в цикле без паузы. Сервер отвечает 429, а при повторе — блокировкой по IP. Даже если лимит не указан, секунда между запросами — разумная вежливость.
- Склейка адреса строками.
url + "?q=" + textломается на пробелах, кириллице и знаке&. Параметры — только черезparams. - Одна и та же выгрузка каждый запуск. Если данные меняются раз в день, сохраните ответ в файл и читайте его, а API спрашивайте только за новым.