Вспомните: в прошлой теме вы вытаскивали из текста телефоны и суммы через re, до этого — разбирали даты через datetime и ловили плохие данные в try/except. Все примеры были на десятке строк. Реальный журнал программы или выгрузка из банка — это сотни тысяч и миллионы строк. Сегодня учим программу переваривать такой файл и не съедать при этом всю память.
🎯 После урока сможете: обработать файл на миллион строк по одной строке, написать свою функцию-генератор с yield, собрать конвейер «прочитать → отфильтровать → разобрать» и посчитать итог через sum и max, не создавая огромных списков.
Файл на миллион строк: почему не список
Представьте журнал программы резервного копирования zhurnal.txt. Каждая строка — дата, время, уровень и сообщение. Вот его начало:
2026-09-01 08:15 INFO запуск
2026-09-01 08:16 ERROR диск заполнен
2026-09-02 09:00 INFO копия готова
2026-09-03 10:30 ERROR нет сети
2026-09-03 10:31 INFO повтор
За год таких строк набирается миллион, файл весит сотни мегабайт. Код lines = f.readlines() или text = f.read() сначала целиком загрузит файл в память, а только потом начнёт считать. На слабом ноутбуке программа задумается надолго или упадёт с MemoryError.
Вы уже знаете способ лучше — цикл по самому файлу. Он читает по одной строке: взял строку, обработал, забыл, взял следующую. В памяти одновременно лежит одна строка, сколько бы их ни было в файле.
from pathlib import Path

errors = 0
with Path("zhurnal.txt").open(encoding="utf-8") as f:
    for line in f:
        if " ERROR " in line:
            errors += 1
print(errors)
2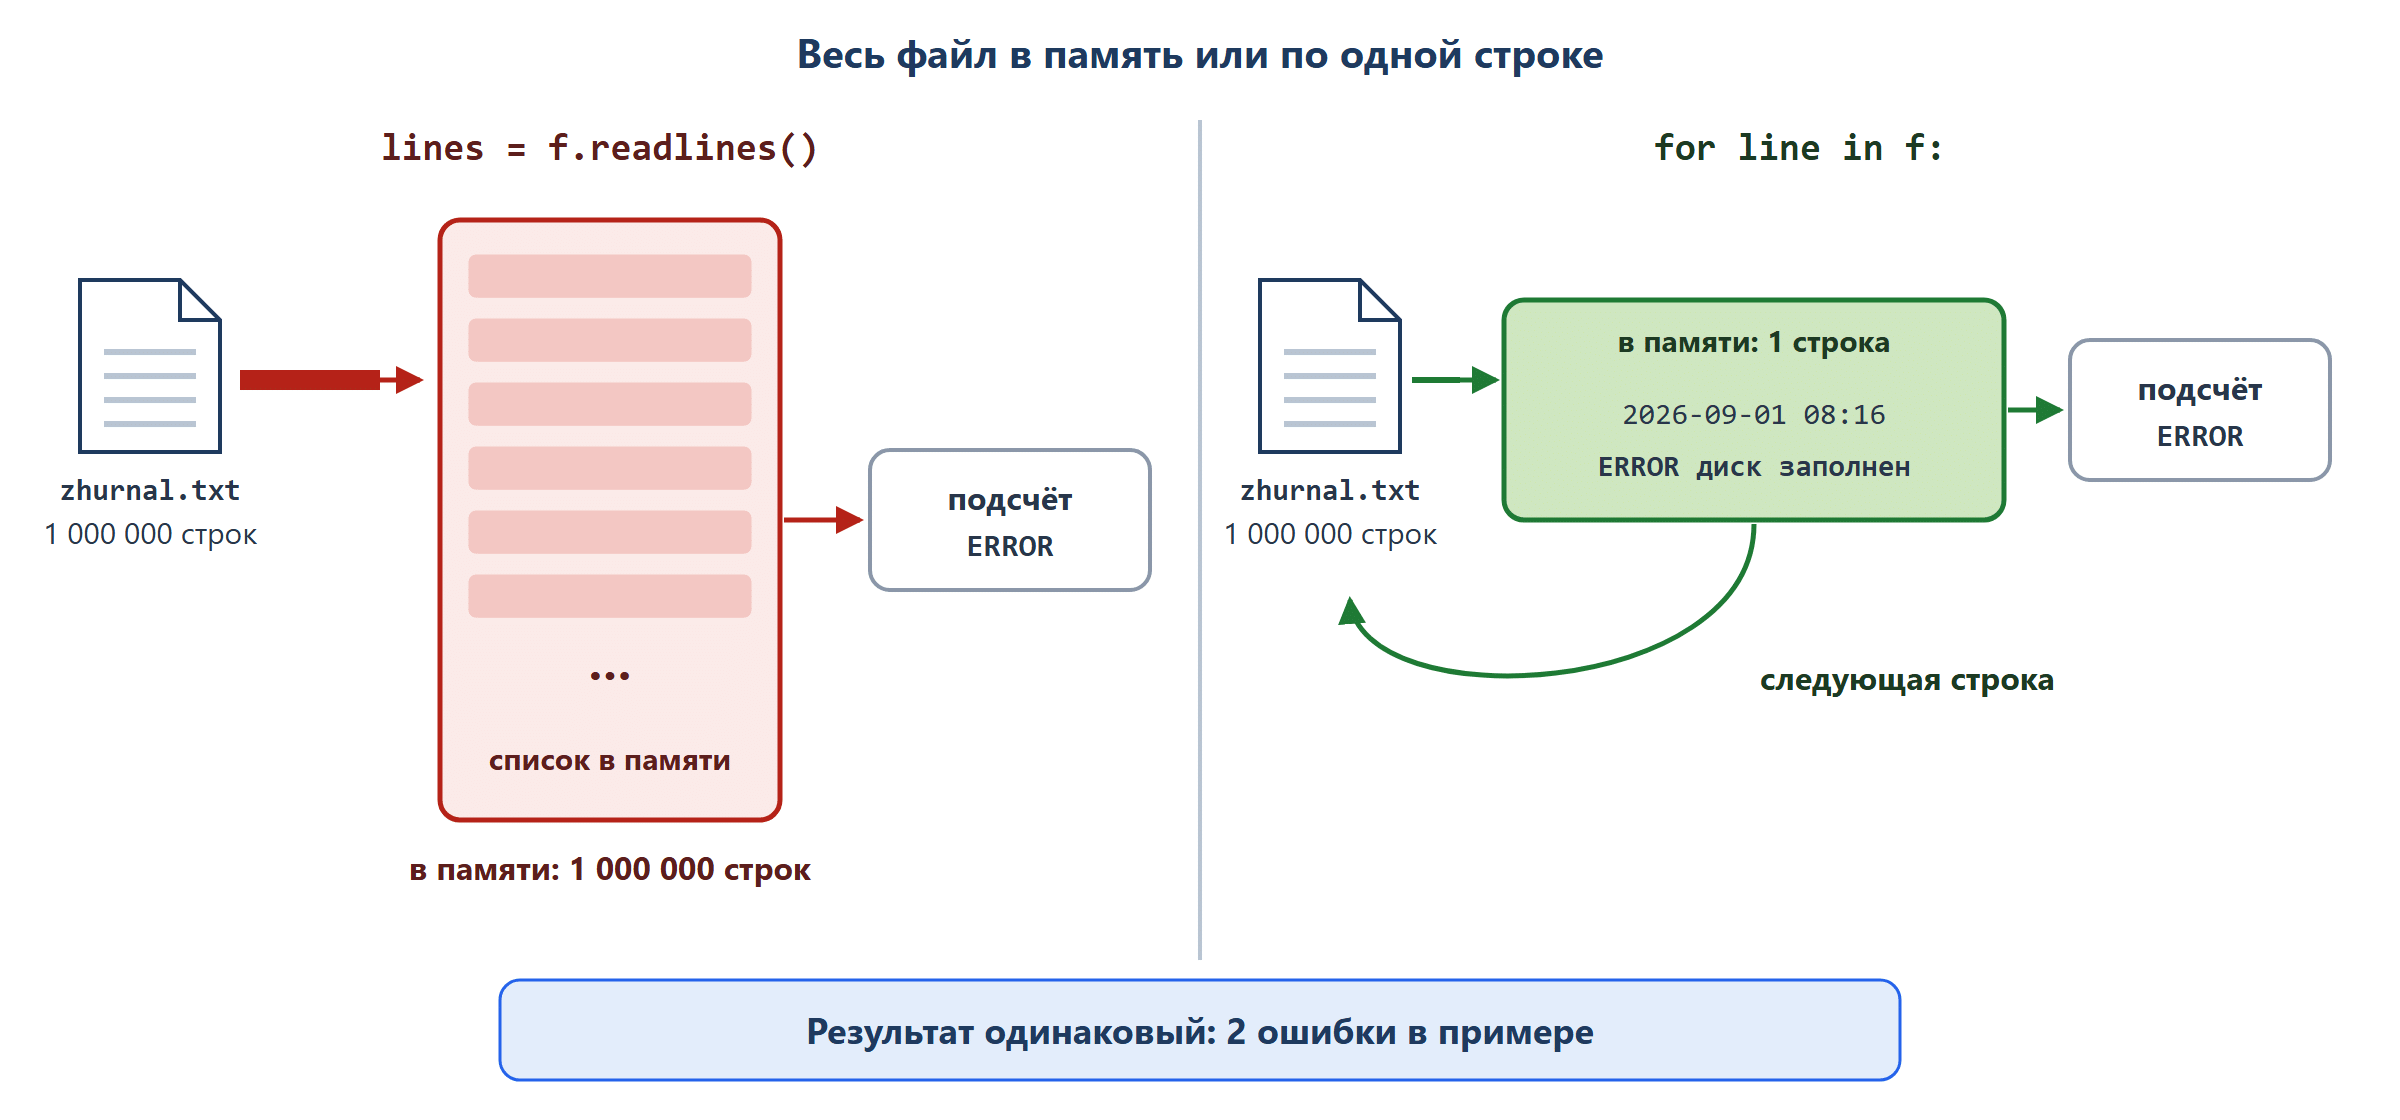
Проверьте себя
Контрольный вопрос. Файл журнала весит 3 ГБ. Какой код посчитает строки с ERROR, читая файл по одной строке? Выберите вариант.
Подсказка: Три варианта из четырёх сначала собирают весь файл в одну переменную. Найдите тот, что этого не делает.
Онлайн-проверка ответа появится позже
Итератор: iter, next и StopIteration
Почему for умеет идти по файлу, списку и строке одинаково? Потому что все они отдают итератор — объект, который выдаёт элементы по одному. Функция iter() получает итератор, функция next() берёт у него следующий элемент.
it = iter(["Еда", "Такси", "Связь"])
print(next(it))
print(next(it))
print(next(it))
Еда
Такси
СвязьЭлементы кончились — следующий next() выбрасывает исключение StopIteration. Его можно поймать, как любое исключение из урока 2.1:
it = iter(["Еда"])
print(next(it))
try:
    next(it)
except StopIteration:
    print("элементы кончились")
Еда
элементы кончилисьЦикл for делает ровно это за вас: вызывает iter(), потом next() раз за разом и тихо останавливается на StopIteration. Открытый файл — сам себе итератор: next(f) вернёт очередную строку. Так удобно пропустить строку заголовка перед циклом:
rows = iter(["дата;сумма", "01.09;450", "02.09;300"])  # так же ведёт себя открытый CSV-файл
header = next(rows)          # забрали заголовок
for row in rows:             # цикл продолжит со второй строки
    print(row.split(";")[1])
450
300Если элемента может не оказаться, передайте в next() второй аргумент — значение по умолчанию. Тогда вместо исключения вернётся оно:
it = iter([])
print(next(it, "пусто"))
пусто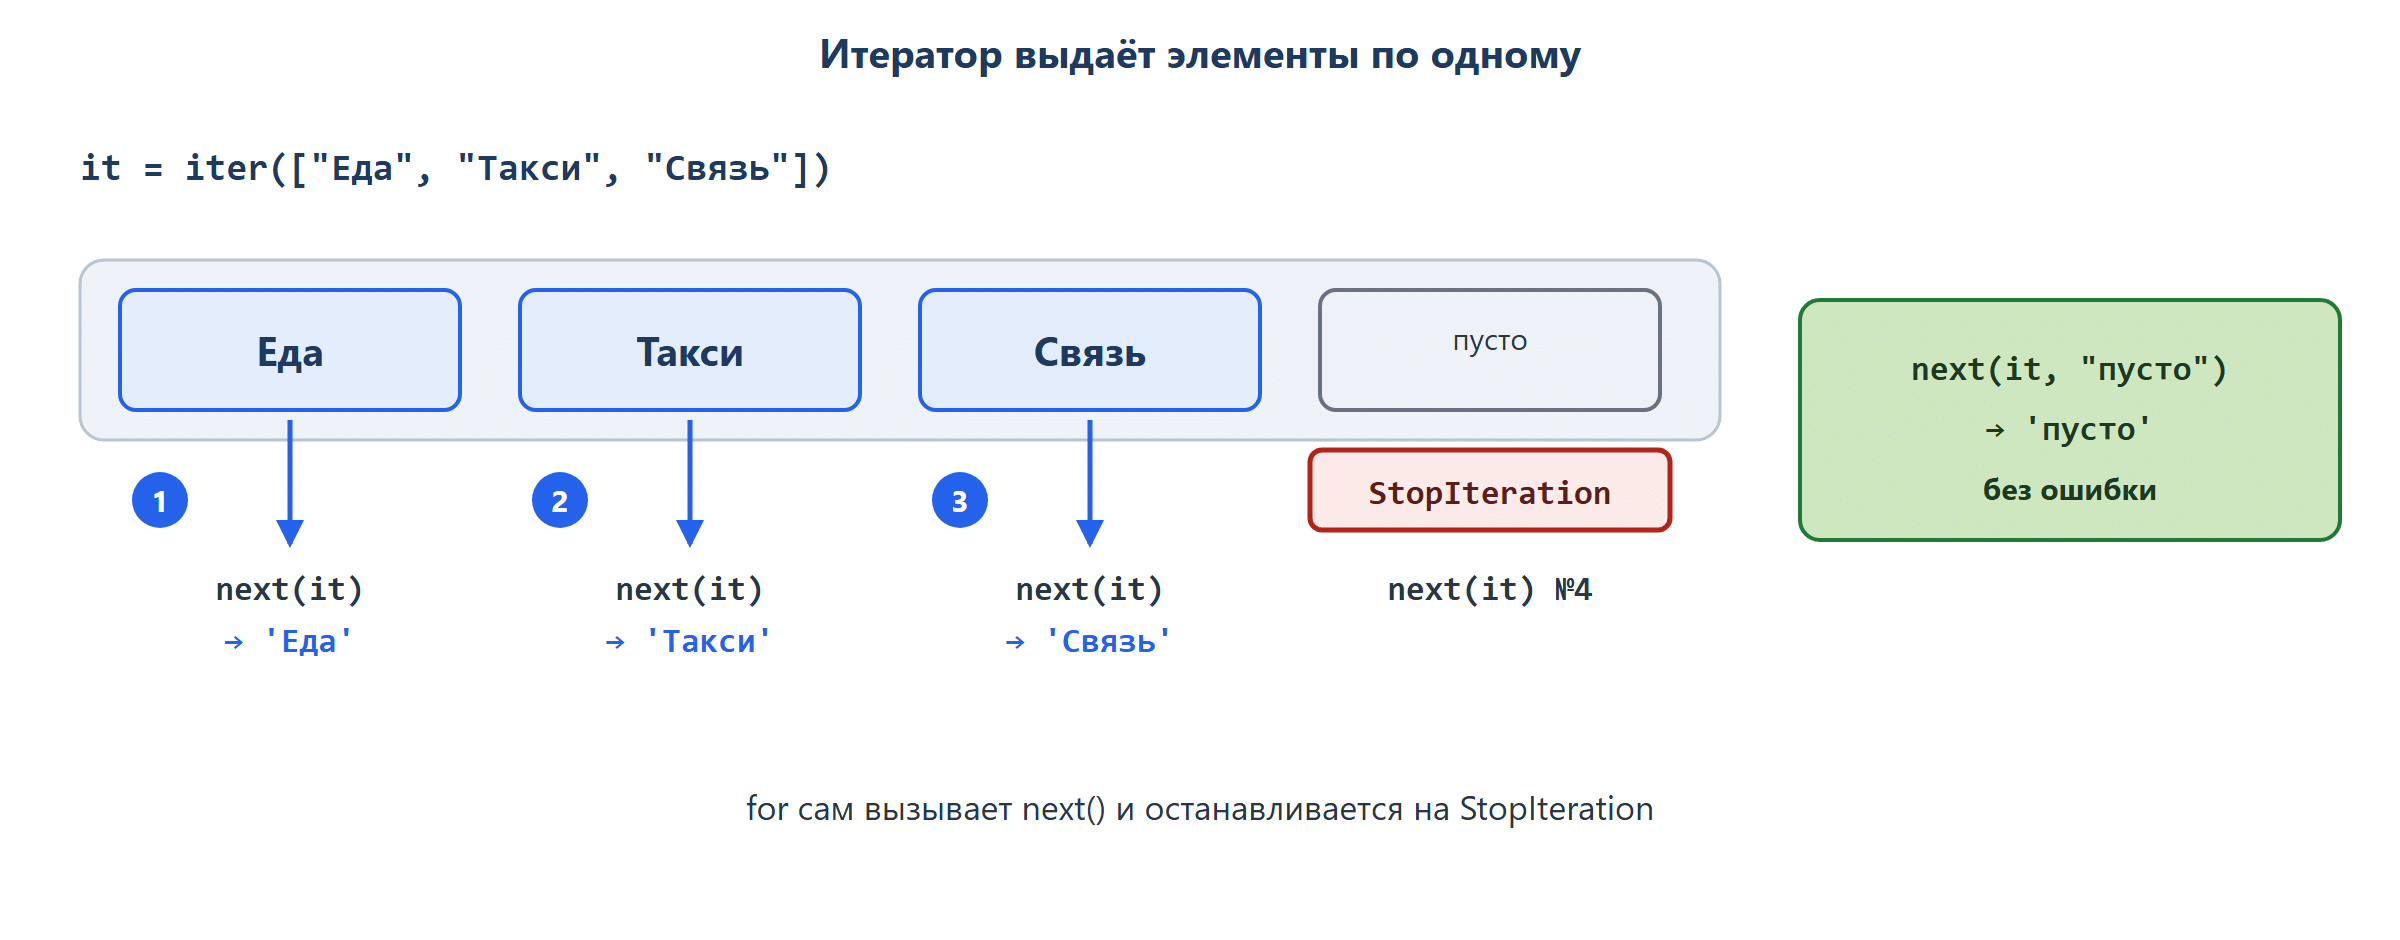
Проверьте себя
Задание. Что выведет программа? Введите слово.
Исходный код для этого задания:
it = iter(["Аренда", "Свет", "Вода"])
next(it)
print(next(it))
Подсказка: Первый next() забрал элемент, хотя его результат никуда не сохранили. Считайте, какой элемент берёт второй.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Программа падает с ошибкой. Какое исключение выбросит последняя строка? Введите имя исключения.
Исходный код для этого задания:
it = iter([1])
next(it)
next(it)
Подсказка: Сколько элементов в итераторе и сколько раз вызван next()? Вспомните, что происходит, когда элементы кончились.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Первая строка выгрузки — заголовок. Что выведет программа? Введите число.
Исходный код для этого задания:
rows = iter(["дата;сумма", "01.09;450", "02.09;300", "03.09;120"])
next(rows)
total = 0
for row in rows:
    total += int(row.split(";")[1])
print(total)
Подсказка: next(rows) до цикла забирает одну строку. Сложите суммы только тех строк, что достались циклу.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
it = iter([10, 20])
print(next(it, 0) + next(it, 0) + next(it, 0))
Подсказка: Второй аргумент next() возвращается, когда элементы кончились. Запишите по порядку, что вернёт каждый вызов.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Функция-генератор: yield
Свой итератор проще всего сделать функцией, в которой вместо return стоит yield. Такая функция называется генератором. Вызов не выполняет её тело, а возвращает объект-генератор. Код внутри запускается, когда у генератора просят значение через next() или цикл for: доходит до yield, отдаёт значение и замирает на этом месте до следующей просьбы.
def countdown(n):
    while n > 0:
        yield n
        n -= 1

g = countdown(3)
print(g)
for x in g:
    print(x)
<generator object countdown at 0x…>
3
2
1Сам print(g) чисел не показал: он сообщил, что в g лежит объект-генератор. Адрес после at 0x у каждого запуска свой. Числа появились, только когда их попросил цикл.
Чтобы увидеть паузы своими глазами, добавим печать внутрь генератора:
def steps():
    print("шаг 1")
    yield "A"
    print("шаг 2")
    yield "B"

g = steps()
print("генератор создан")
print(next(g))
print(next(g))
генератор создан
шаг 1
A
шаг 2
B- После
g = steps()не напечаталось ничего из функции: тело ещё не начало работать. - Каждый
next(g)выполняет код до ближайшегоyieldи возвращает его значение. - Когда функция дошла до конца, генератор выбрасывает
StopIteration, и циклforзавершается. list(g)соберёт все значения генератора в список — удобно для проверки на маленьких данных, но на миллионе строк список снова займёт всю память.
Главное применение для нас — генератор, который читает файл и отдаёт строки уже очищенными. Снаружи им пользуются как обычным циклом, а файл по-прежнему читается по одной строке:
from pathlib import Path

def read_lines(path):
    with Path(path).open(encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if line:
                yield line

for line in read_lines("zhurnal.txt"):
    print(line[:10])
2026-09-01
2026-09-01
2026-09-02
2026-09-03
2026-09-03Проверьте себя
Контрольный вопрос. Что окажется в переменной g после строки g = countdown(3)? Выберите вариант.
Исходный код для этого задания:
def countdown(n): while n > 0: yield n n -= 1 g = countdown(3)Подсказка: Вспомните пример steps(): что напечаталось сразу после создания генератора?
Онлайн-проверка ответа появится позже
Задание. Что выведет программа? Введите список так, как его напечатает Python.
Исходный код для этого задания:
def evens(n):
    for i in range(n):
        if i % 2 == 0:
            yield i

print(list(evens(7)))
Подсказка: Пройдите range(7) по шагам и выпишите числа, на которых срабатывает yield.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Функция должна отдавать строки по одной, а сейчас возвращает только первую и завершается. Какое слово нужно поставить вместо return? Введите одно слово.
Исходный код для этого задания:
def only_errors(lines):
    for line in lines:
        if "ERROR" in line:
            return line
Подсказка: Вспомните, чем функция-генератор отличается от обычной функции: какое ключевое слово в её теле отдаёт значение наружу?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Что выведет программа первой строкой? Введите это слово.
Исходный код для этого задания:
def gen():
    print("внутри")
    yield 1

g = gen()
print("снаружи")
print(next(g))
Подсказка: Разберите по строкам: какая строка программы первой приводит к печати? Вспомните, когда начинает выполняться тело генератора.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Генераторное выражение
Для простых случаев функцию писать не нужно. Генераторное выражение выглядит как списковое включение, только в круглых скобках: (выражение for x in набор if условие). Список из квадратных скобок создаётся целиком сразу, генератор из круглых — выдаёт значения по одному.
amounts = ["450", "380", "н/д", "620"]
lens_list = [len(s) for s in amounts]   # готовый список
lengths = (len(s) for s in amounts)          # генератор, ещё ничего не посчитано
print(lens_list)
print(sum(lengths))
[3, 3, 3, 3]
12Если генератор — единственный аргумент функции, вторые скобки можно не писать: sum(x for x in ...). Так считают итог прямо по файлу, не заводя список:
from pathlib import Path

with Path("zhurnal.txt").open(encoding="utf-8") as f:
    errors = sum(1 for line in f if " ERROR " in line)
print(errors)2Функции sum, max, min принимают генератор так же, как список. У max работает и знакомый параметр key. Ещё две полезные функции отвечают «да или нет»: any(…) — True, если истинно хотя бы одно значение, all(…) — True, если истинны все. Обе останавливаются, как только ответ ясен.
amounts = ["450", "н/д", "620"]
print(any(s.isdigit() for s in amounts))
print(all(s.isdigit() for s in amounts))
True
FalseПроверьте себя
Задание. В выгрузке попадаются пропуски «н/д». Что выведет программа? Введите число.
Исходный код для этого задания:
amounts = ["450", "380", "н/д", "620", "—"]
print(sum(int(s) for s in amounts if s.isdigit()))
Подсказка: isdigit() пропускает только строки из цифр. Сложите суммы, которые пройдут фильтр.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Перед подсчётом программа проверяет выгрузку. Что она выведет? Введите два слова через пробел, как в выводе.
Исходный код для этого задания:
amounts = ["—", "н/д", "", "12р"]
print(any(s.isdigit() for s in amounts), all(s != "" for s in amounts))
Подсказка: Для any ищите хотя бы одну строку из одних цифр, для all проверьте, что пустых строк нет совсем.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Конвейер: чтение → фильтр → разбор
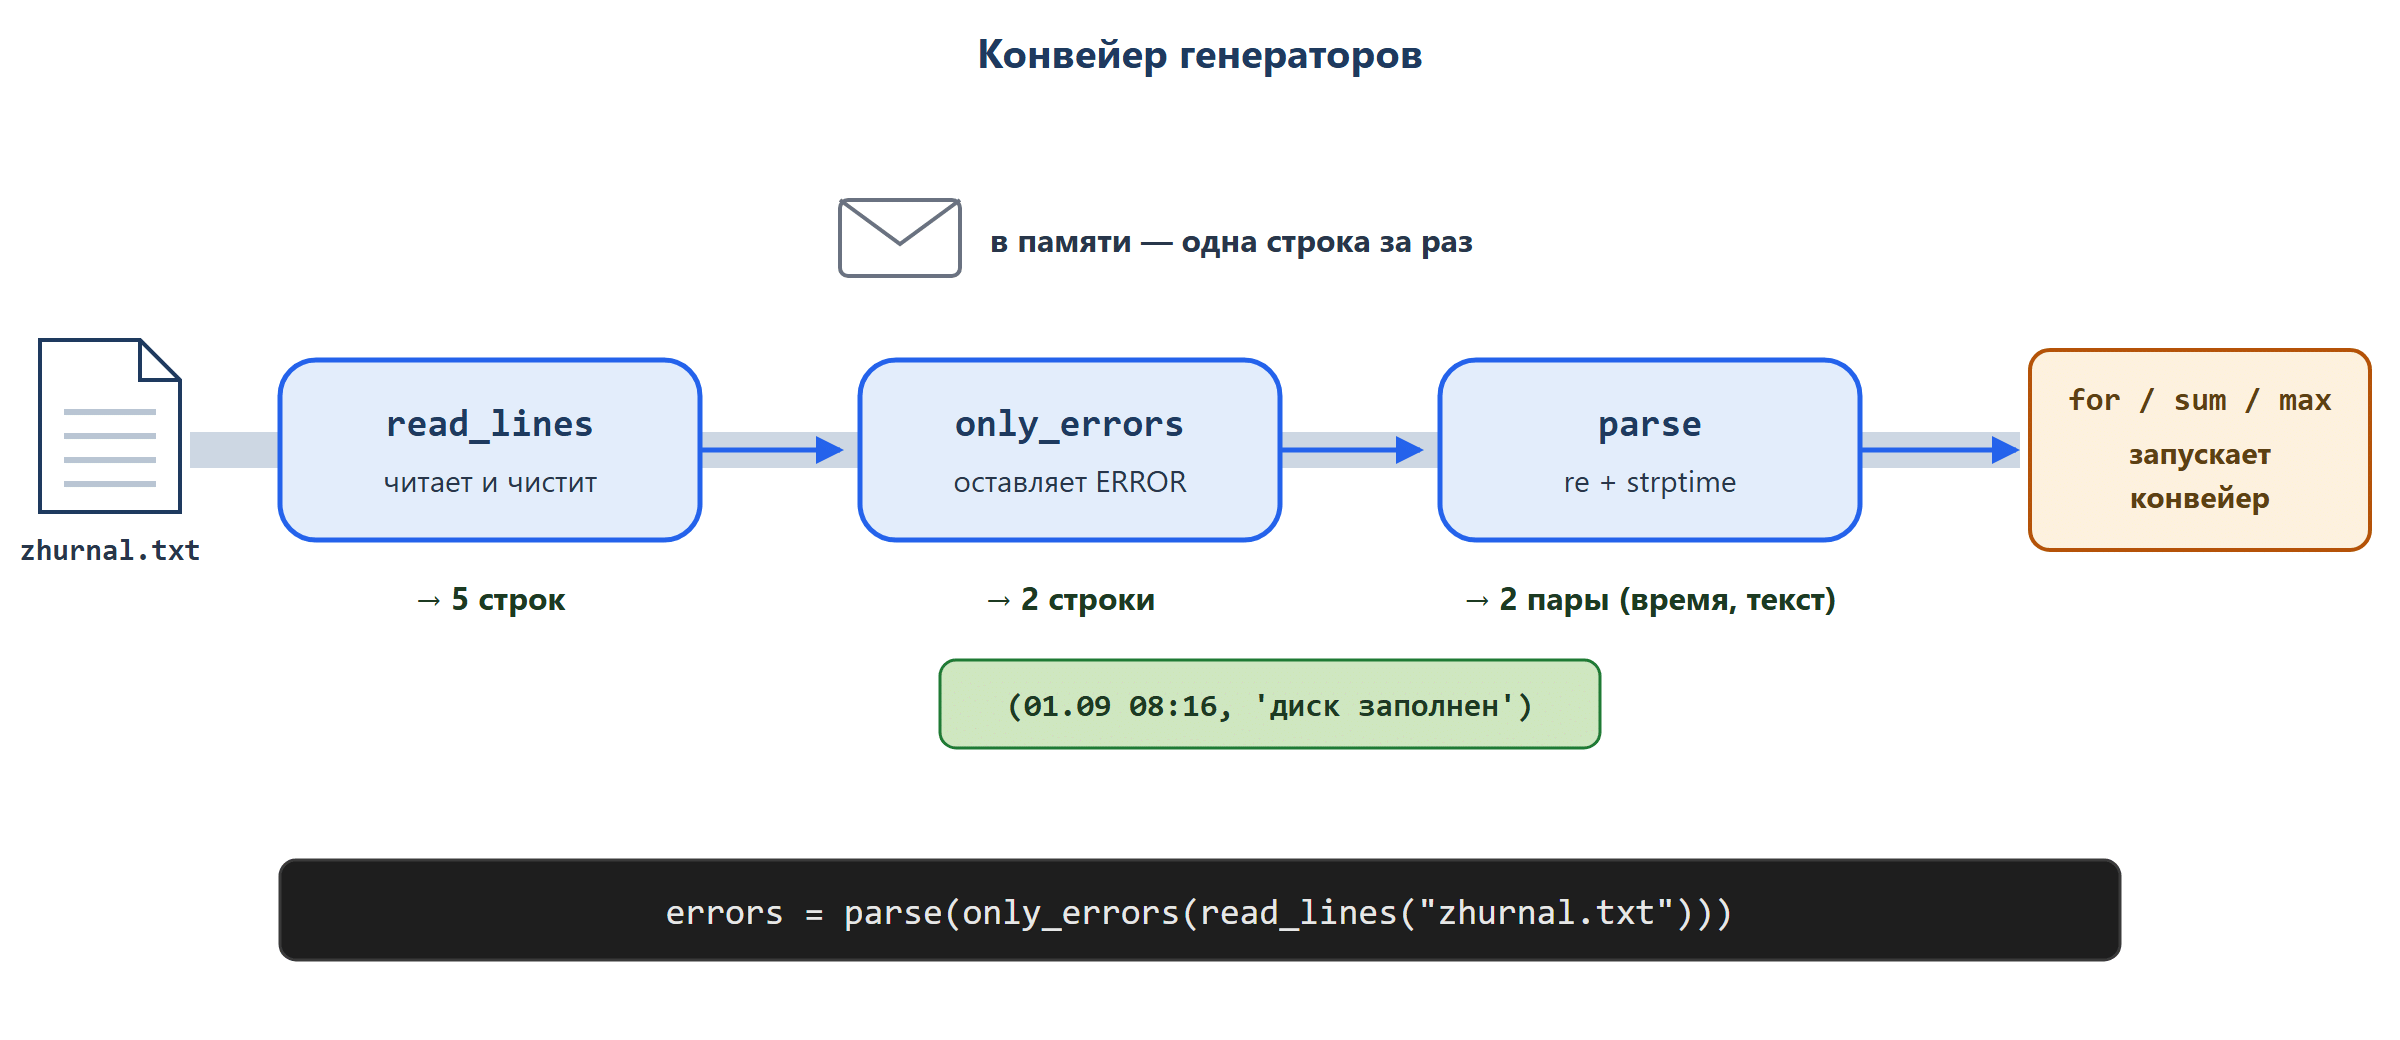
Самый полезный приём урока — соединить несколько генераторов цепочкой. Каждый делает одно дело и передаёт строку дальше. Строка проходит весь конвейер, и только потом читается следующая: в памяти по-прежнему одна строка.
import re
from datetime import datetime
from pathlib import Path

def read_lines(path):
    with Path(path).open(encoding="utf-8") as f:
        for line in f:
            yield line.strip()

def only_errors(lines):
    for line in lines:
        if " ERROR " in line:
            yield line

def parse(lines):
    for line in lines:
        m = re.search(r"^(\S+ \S+) ERROR (.+)", line)
        if m:
            yield datetime.strptime(m.group(1), "%Y-%m-%d %H:%M"), m.group(2)

errors = parse(only_errors(read_lines("zhurnal.txt")))
for when, text in errors:
    print(when.strftime("%d.%m %H:%M"), text)
01.09 08:16 диск заполнен
03.09 10:30 нет сетиread_linesчитает файл и чистит строки.only_errorsпропускает дальше только строки с ERROR.parseрегулярным выражением делит строку на время и текст, а время превращает вdatetimeпо формату%Y-%m-%d %H:%Mиз урока 2.2. В шаблоне знакомые из урока 2.3 знаки:^— начало строки,\S+— подряд идущие символы без пробелов (дата, потом время).- Пока не запущен цикл, ни один генератор не прочитал ни строки: строка
errors = …лишь собирает конвейер.
Итог по конвейеру считают теми же sum и max. Например, самая поздняя ошибка:
import re
from datetime import datetime

lines = ["2026-09-01 08:16 ERROR диск заполнен", "2026-09-03 10:30 ERROR нет сети"]
times = (datetime.strptime(re.search(r"^(\S+ \S+)", s).group(1), "%Y-%m-%d %H:%M") for s in lines)
print(max(times))
2026-09-03 10:30:00Проверьте себя
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
def only_errors(lines):
    for line in lines:
        if "ERROR" in line:
            yield line

def sizes(lines):
    for line in lines:
        yield int(line.split()[-1])

log = ["INFO копия 120", "ERROR копия 40", "ERROR архив 75", "INFO архив 300"]
print(sum(sizes(only_errors(log))))
Подсказка: Пройдите конвейер по шагам: какие строки пропустит only_errors, какое число sizes достанет из каждой?
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Задание. Программа ищет день, когда за одну покупку потратили больше всего. Что она выведет? Введите дату так, как её напечатает программа.
Исходный код для этого задания:
import re

log = ["01.09 чек: 450 руб", "02.09 возврат", "03.09 чек: 1 280 руб", "05.09 чек: 990 руб"]

def checks(lines):
    for line in lines:
        m = re.search(r"(\d\d\.\d\d) чек: ([\d ]+) руб", line)
        if m:
            yield m.group(1), int(m.group(2).replace(" ", ""))

def by_amount(pair):
    return pair[1]

day, amount = max(checks(log), key=by_amount)
print(day)
Подсказка: Выпишите пары, которые отдаст checks: какие строки подходят под шаблон и что станет с пробелом внутри суммы? by_amount возвращает второй элемент пары — по нему max и сравнивает.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Ловушка: генератор одноразовый
Генератор выдаёт каждое значение ровно один раз. Прошли по нему до конца — он пуст, второй проход не даст ничего. Ошибки не будет, просто пустой результат:
nums = (int(s) for s in ["450", "380", "620"])
print(sum(nums))
print(sum(nums))
1450
0С файлом то же самое: второй for line in f по уже прочитанному файлу не выполнится ни разу. Три способа выйти из ловушки:
- посчитать всё за один проход — завести несколько переменных и обновлять их в одном цикле;
- создать генератор заново — ещё раз вызвать функцию
read_lines("zhurnal.txt"), она снова откроет файл; - если данных мало — сохранить их в список
list(...)и ходить по нему сколько угодно.
from pathlib import Path

total = 0
errors = 0
with Path("zhurnal.txt").open(encoding="utf-8") as f:
    for line in f:
        total += 1
        if " ERROR " in line:
            errors += 1
print(errors, "из", total)
2 из 5Сделайте у себя файл
zhurnal.txtиз начала урока, размножьте строки циклом до миллиона (f.write(line)вfor i in range(200_000)) и сравните: сколько думаетreadlines()и сколько — цикл по файлу. Посмотрите память в диспетчере задач.
Проверьте себя
Задание. Что выведет второй print? Введите число.
Исходный код для этого задания:
nums = (x * 2 for x in [1, 2, 3])
print(max(nums))
print(len(list(nums)))
Подсказка: max прошёл генератор до конца, чтобы найти наибольшее. Что осталось в генераторе после этого?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Программа считает средний чек и падает с ZeroDivisionError. Какая правка первой строки её починит? Выберите вариант.
Исходный код для этого задания:
amounts = (int(s) for s in ["450", "380", "620"]) total = sum(amounts) count = len(list(amounts)) print(total / count)Подсказка: Почему count оказался нулём? Нужен вариант, по которому можно пройти дважды.
Онлайн-проверка ответа появится позже
Проектные миссии
Задание. Проектная миссия «Ошибки за неделю». Сохраните данные ниже в файл server.log (кодировка utf-8). Напишите конвейер из трёх функций-генераторов: read_lines(path) читает файл по строке и отдаёт непустые строки без пробелов по краям; only_errors(lines) пропускает строки с уровнем ERROR; parse(lines) через re и datetime.strptime превращает строку в пару (время, текст). По конвейеру посчитайте через sum, сколько ошибок случилось с 8 по 14 сентября 2026 года включительно. Списков из всех строк файла не создавать. Потом запустите утилиту на журнале своей программы. Приложите файл программы .py; в поле ответа — число.
Принято, если:
1. число совпадает с эталоном;
2. приложен .py, который его выдаёт на данных из условия.Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. три отдельные функции с yield, соединённые цепочкой; файл читается циклом по строкам, без readlines() и read().2026-09-01 10:56 ERROR нет сети
2026-09-01 18:45 INFO запуск
2026-09-02 01:38 ERROR нет доступа
2026-09-02 02:38 INFO запуск
2026-09-02 05:55 INFO запуск
2026-09-02 09:16 ERROR диск заполнен
2026-09-02 11:49 INFO проверка ок
2026-09-03 01:10 ERROR файл занят
2026-09-03 01:15 WARNING мало места
2026-09-03 07:00 ERROR нет сети
2026-09-03 19:34 ERROR нет сети
2026-09-04 05:47 INFO запуск
2026-09-04 15:00 INFO запуск
2026-09-05 03:40 INFO проверка ок
2026-09-05 19:16 WARNING медленная сеть
2026-09-06 12:02 INFO запуск
2026-09-06 14:46 INFO проверка ок
2026-09-07 02:37 ERROR нет доступа
2026-09-07 04:31 INFO проверка ок
2026-09-08 13:20 WARNING мало места
2026-09-08 13:39 WARNING мало места
2026-09-09 20:37 ERROR диск заполнен
2026-09-10 21:47 WARNING мало места
2026-09-10 22:46 ERROR нет доступа
2026-09-11 10:11 INFO копия готова
2026-09-11 12:55 INFO запуск
2026-09-12 01:47 INFO копия готова
2026-09-12 01:53 ERROR нет доступа
2026-09-12 05:25 WARNING медленная сеть
2026-09-12 12:43 INFO запуск
2026-09-12 19:33 ERROR нет сети
2026-09-12 20:07 INFO запуск
2026-09-13 02:55 INFO копия готова
2026-09-13 07:37 INFO копия готова
2026-09-13 18:26 WARNING мало места
2026-09-13 22:59 WARNING мало места
2026-09-14 13:03 ERROR файл занят
2026-09-14 17:52 WARNING медленная сеть
2026-09-14 20:55 ERROR нет сети
2026-09-15 10:30 INFO проверка ок
2026-09-15 13:01 ERROR диск заполнен
2026-09-15 16:10 ERROR файл занят
2026-09-15 17:11 WARNING мало места
2026-09-15 20:46 WARNING мало места
2026-09-16 05:39 INFO проверка ок
2026-09-17 14:55 INFO проверка ок
2026-09-17 16:25 WARNING медленная сеть
2026-09-17 21:05 INFO запуск
2026-09-18 06:47 INFO проверка ок
2026-09-18 08:48 INFO запуск
2026-09-18 16:17 WARNING мало места
2026-09-18 16:21 INFO копия готова
2026-09-19 22:53 WARNING медленная сеть
2026-09-20 04:36 INFO копия готова
2026-09-20 16:33 ERROR диск заполнен
2026-09-21 17:16 ERROR файл занят
Подсказка: Сравнивайте datetime, а не строки: граница «14 сентября включительно» — это всё, что раньше datetime(2026, 9, 15). Проверьте конвейер сначала на пяти строках из урока.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Задание. Проектная миссия «Траты по выходным». Банк выгрузил платежи за сентябрь: сохраните данные ниже в файл platezhi.csv (кодировка utf-8, разделитель ;, первая строка — заголовок). В столбце суммы попадается мусор: пусто, «н/д», «—», опечатки; у больших сумм есть пробел между тысячами. Напишите генератор read_rows(path): пропускает заголовок через next(f) и отдаёт строки списком ячеек. Второй генератор amounts(rows) убирает пробелы из суммы, переводит её в int, мусор пропускает через try/except ValueError и отдаёт только платежи, сделанные в субботу или воскресенье (datetime.strptime и weekday()). Итог посчитайте sum по конвейеру. Приложите файл программы .py; в поле ответа — число.
Принято, если:
1. число совпадает с эталоном;
2. приложен .py, который его выдаёт на данных из условия.Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. программа не падает ни на одной строке с мусором, а плохие строки не молча теряются в общем except — ловится именно ValueError.id;дата;сумма
1;16.09.2026;7139
2;23.09.2026;н/д
3;04.09.2026;17 863
4;25.09.2026;21114
5;28.09.2026;20025
6;25.09.2026;11734
7;04.09.2026;24903
8;07.09.2026;21367
9;05.09.2026;12o0
10;04.09.2026;13 302
11;20.09.2026;6023
12;04.09.2026;23898
13;13.09.2026;19 558
14;27.09.2026;16120
15;27.09.2026;19512
16;11.09.2026;7 786
17;16.09.2026;15 689
18;29.09.2026;20388
19;15.09.2026;6 295
20;24.09.2026;19 850
21;20.09.2026;24609
22;28.09.2026;19164
23;21.09.2026;ошибка
24;12.09.2026;9669
25;03.09.2026;10791
26;05.09.2026;384
27;23.09.2026;19751
28;16.09.2026;18657
29;23.09.2026;3 624
30;15.09.2026;3805
31;28.09.2026;—
32;29.09.2026;н/д
33;10.09.2026;23007
34;03.09.2026;22788
35;02.09.2026;18051
36;23.09.2026;1 926
37;20.09.2026;15 628
38;26.09.2026;
39;05.09.2026;20727
40;25.09.2026;21328
41;02.09.2026;1771
42;23.09.2026;22 986
43;18.09.2026;12o0
44;09.09.2026;20 903
45;04.09.2026;10 738
46;24.09.2026;9268
47;28.09.2026;22976
48;27.09.2026;н/д
49;22.09.2026;1 041
50;04.09.2026;19722
51;25.09.2026;19 371
52;13.09.2026;13690
Подсказка: weekday() возвращает 0 для понедельника; какие номера у субботы и воскресенья — проверьте на известной дате. Сначала выведите пары (дата, сумма) для первых строк и убедитесь, что мусор отсеялся.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Что дальше
Теперь вы умеете обрабатывать файл любого размера по одной строке, получать элементы через iter и next, писать функции-генераторы с yield, собирать из них конвейер «чтение → фильтр → разбор» и считать итог через sum и max. И помните: генератор проходится один раз. Глава 2 закончена — ваши программы не падают на плохих данных, считают даты, вытаскивают нужное из текста и не боятся больших файлов. Следующая глава курса — в навигаторе.
← Назад · ↑ В начало урока · ⌂ К навигатору курса · Вперёд →