Вспомните: в прошлом уроке вы считали даты — сколько дней до оплаты, какой день недели у платежа. Даты вы брали из аккуратных строк вида 05.09.2026. В жизни нужное число чаще спрятано внутри текста: в СМС из банка, в письме, в выгрузке чата. Методы строк find и split тут быстро упираются в разнобой записей. Для этого есть регулярные выражения.
🎯 После урока сможете: составить шаблон под телефон, почту или сумму, вытащить из текста все совпадения через re.findall, разобрать найденное на части группами и заменить или скрыть кусок текста через re.sub.
Шаблон и re.search: первое совпадение
Регулярное выражение — это шаблон, описание того, как выглядит нужный кусок текста. Модуль re встроен в Python. Функция re.search(шаблон, текст) ищет первое место, где текст подходит под шаблон. Нашла — возвращает объект совпадения, у которого .group() отдаёт найденный кусок. Не нашла — возвращает None.
import re

text = "Списание 450 руб. Магазин у дома"
m = re.search(r"руб", text)
print(m.group())
print(re.search(r"евро", text))
руб
NoneПока шаблон — просто слово, и search работает как find. Сила появится, когда в шаблоне будут метасимволы — знаки со особым смыслом. Их введём по одному.
Перед кавычками стоит буква r — это сырая строка. В обычной строке Python сам разбирает обратную косую черту: "\n" — перенос строки, "\b" — служебный символ. В шаблонах обратная черта встречается постоянно, и она должна дойти до модуля re нетронутой. r"…" говорит Python: косые черты не трогай.
print(len("\\b"), len(r"\b"))
print(len("\b"))
2 2
1В обычной строке "\\b" — две черты, которые Python склеивает в одну, а "\b" — уже совсем другой, служебный символ длиной 1. Сырая строка r"\b" хранит ровно то, что написано: обратную черту и букву.
Правило простое: шаблон регулярного выражения всегда пишите как
r"…". Так не придётся думать, какие косые черты Python съест сам.
Совпадение проверяют через if: объект совпадения считается истиной, None — ложью. Без проверки .group() на None уронит программу с ошибкой AttributeError.
import re

for line in ["Оплата 300 руб", "Привет!"]:
    m = re.search(r"руб", line)
    if m:
        print("есть сумма:", line)
    else:
        print("пропускаем:", line)
есть сумма: Оплата 300 руб
пропускаем: Привет!Проверьте себя
Задание. Что выведет программа? Введите ответ так, как его напечатает Python.
Исходный код для этого задания:
import re

text = "Пополнение 2000 руб. через банкомат"
print(re.search(r"Списание", text))
Подсказка: Что возвращает re.search, если шаблона в тексте нет?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Цифры и повторы: \d, + и {n}
Первый метасимвол — \d: одна любая цифра от 0 до 9. Шаблон r"\d" найдёт первую цифру в тексте.
import re

print(re.search(r"\d", "Заказ 1542 от 03.09").group())1Одна цифра — мало. Знаки повтора ставят сразу после символа, который повторяется:
+— один раз или больше:\d+— число любой длины;{4}— ровно 4 раза:\d{4}— четыре цифры подряд;{2,4}— от 2 до 4 раз.
import re

text = "Заказ 1542 от 03.09.2026"
print(re.search(r"\d+", text).group())
print(re.search(r"\d{2}", text).group())
1542
15\d+ забрал все четыре цифры номера заказа: повтор берёт столько символов, сколько может. \d{2} остановился на двух — и это первые две цифры того же номера, ведь search берёт самое первое подходящее место.
Проверьте себя
Контрольный вопрос. В строке «Отчёт за 2026 год, файл 7» нужно найти год — ровно четыре цифры подряд. Какой шаблон подходит? Выберите вариант.
Подсказка: Число повторов пишут в фигурных скобках сразу после символа. Проверьте, где в каждом варианте стоит обратная черта.
Онлайн-проверка ответа появится позже
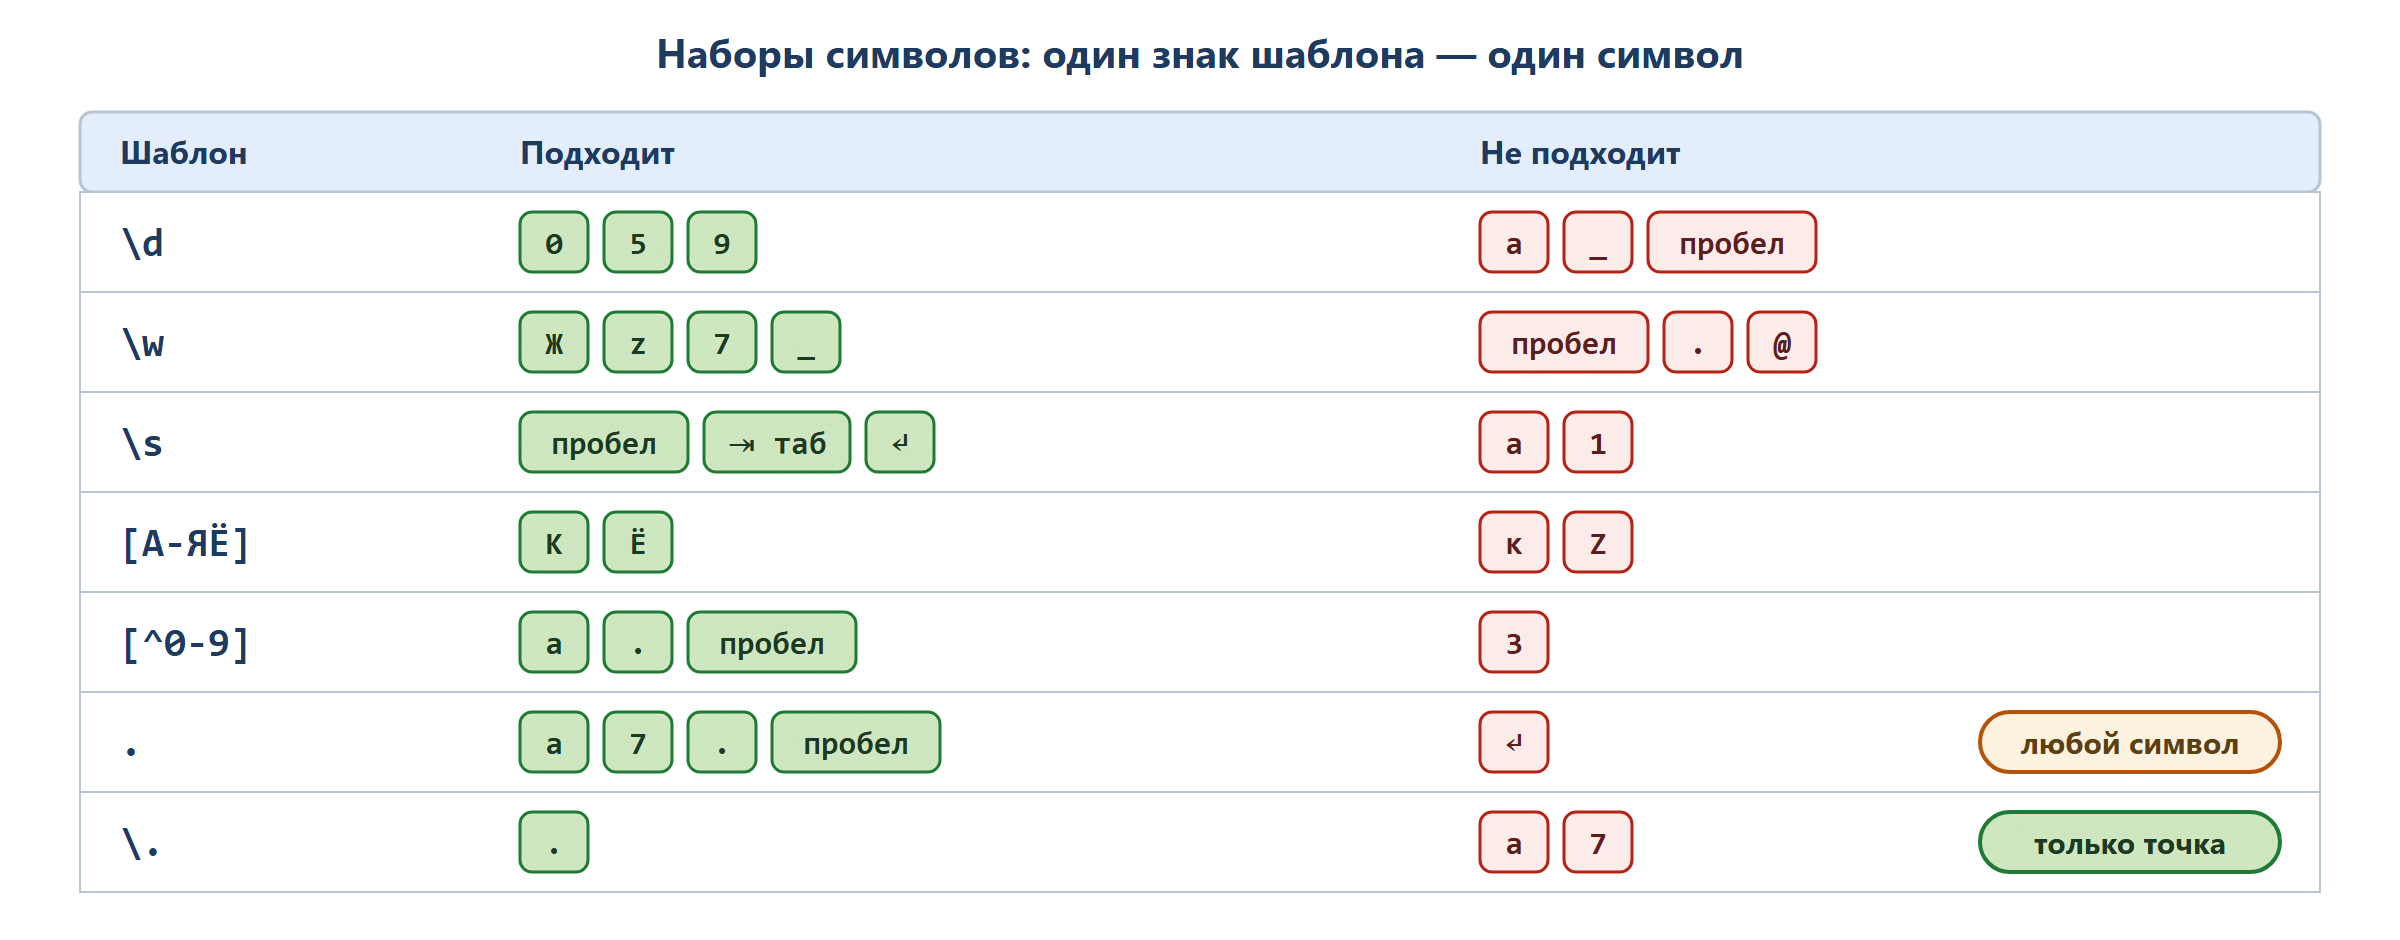
Наборы символов: [ ], \w, \s и точка
Квадратные скобки задают набор: один символ из перечисленных. Внутри можно писать диапазоны.
[аеиоу]— одна из этих букв;[0-9]— то же, что\d;[А-ЯЁ]— одна заглавная русская буква (Ё стоит в алфавите Unicode отдельно, её добавляют руками);[^0-9]— знак^в начале набора значит «любой символ, кроме перечисленных».
Для частых наборов есть сокращения:
\w— буква (русская тоже), цифра или подчёркивание — символ «слова»;\s— пробельный символ: пробел, табуляция, перенос строки;\D,\W,\S— заглавная буква переворачивает смысл: не цифра, не символ слова, не пробел.
import re

text = "Доставка в Казань, заказ №77"
print(re.search(r"[А-ЯЁ]\w+", text).group())
print(re.search(r"№\d+", text).group())
print(re.search(r"\s\w+,", text).group())
Доставка
№77
Казань,Отдельно — точка. В шаблоне . значит «любой один символ, кроме переноса строки». Чтобы искать саму точку, например в сумме 450.50 или в почте, её экранируют: \.. То же с другими метасимволами: \+ — сам плюс, \( — сама скобка.
import re

for s in ["450.50", "45050"]:
    print(s, re.search(r"\d+.\d+", s) is not None, re.search(r"\d+\.\d+", s) is not None)
450.50 True True
45050 True FalseШаблон с голой точкой нашёл «дробь» и в числе 45050, где никакой точки нет: точка съела цифру 0. С \. ошибки нет.
Проверьте себя
Задание. Что выведет программа? Введите слово.
Исходный код для этого задания:
import re

text = "курьер будет в Самаре к 18:00"
print(re.search(r"[А-ЯЁ]\w+", text).group())
Подсказка: Набор [А-ЯЁ] требует заглавную букву. С какой буквы начинается первое подходящее слово?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Нужно найти в тексте сумму вида «3.5» — цифра, точка, цифра. В числе «345» совпадения быть не должно. Какой шаблон подходит? Выберите вариант.
Подсказка: Что в шаблоне значит голая точка и чем она отличается от точки с обратной чертой?
Онлайн-проверка ответа появится позже
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
import re

text = "Заказ 12 от 5 мая, 3 шт"
print(len(re.findall(r"[^\d\s]+", text)))
Подсказка: Набор с ^ в начале берёт любые символы, кроме перечисленных. Разделите строку там, где стоят цифры и пробелы, и посчитайте оставшиеся куски.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
re.findall: все совпадения сразу
search останавливается на первом совпадении. re.findall(шаблон, текст) возвращает список всех найденных кусков — строками. Пусто — пустой список, не None.
import re

sms = "Кофе 250 руб, круассан 180 руб, доставка 99 руб"
amounts = re.findall(r"\d+", sms)
print(amounts)
print(sum(int(a) for a in amounts))
print(re.findall(r"\d+", "без чисел"))
['250', '180', '99']
529
[]Найденное — строки, поэтому перед сложением каждую переводим в int, как с ячейками CSV в главе 1.
Проверьте себя
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
import re

text = "3 кофе по 250 и 1 торт за 900, итого 1650"
print(len(re.findall(r"\d+", text)))
Подсказка: findall собирает каждое число целиком — посчитайте отдельные группы цифр в строке.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Необязательное: ? и *
Ещё два знака повтора:
?— ноль или один раз, то есть «может быть, а может не быть»;*— ноль или больше раз.
Люди пишут одно и то же по-разному: «300₽» и «300 ₽», «e-mail» и «email». Знак ? после пробела или дефиса делает его необязательным.
import re

text = "Чай 300₽, пирог 450 ₽, вода 60р"
print(re.findall(r"\d+ ?₽", text))
print(re.findall(r"e-?mail", "email, e-mail, e--mail"))
print(re.findall(r"\d+-*\d+", "12-34 5678 9--0"))
['300₽', '450 ₽']
['email', 'e-mail']
['12-34', '5678', '9--0']Во второй строке e--mail не подошёл: ? разрешает не больше одного дефиса. * в третьей строке пропустил сколько угодно дефисов, включая ни одного.
Проверьте себя
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
import re

text = "Кофе 300₽, пирог 450 ₽, вилки 12 шт, сок 90  ₽"
print(len(re.findall(r"\d+ ?₽", text)))
Подсказка: Пробел со знаком ? может быть один или ни одного. Проверьте каждую сумму: сколько пробелов между числом и ₽?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Нужен шаблон, который найдёт и «email», и «e-mail», но не «mail». Выберите вариант.
Подсказка: Знак ? относится только к символу прямо перед ним. Какой символ здесь должен стать необязательным?
Онлайн-проверка ответа появится позже
Контрольный вопрос. Номера квитанций пишут по-разному: «90», «9-0», «9—0». Какой шаблон найдёт все три записи целиком? Выберите вариант.
Подсказка: Сколько дефисов между цифрами встречается в трёх записях: самое малое и самое большое? Какой знак повтора разрешает оба крайних случая?
Онлайн-проверка ответа появится позже
Группы ( ): разбираем телефон и почту на части
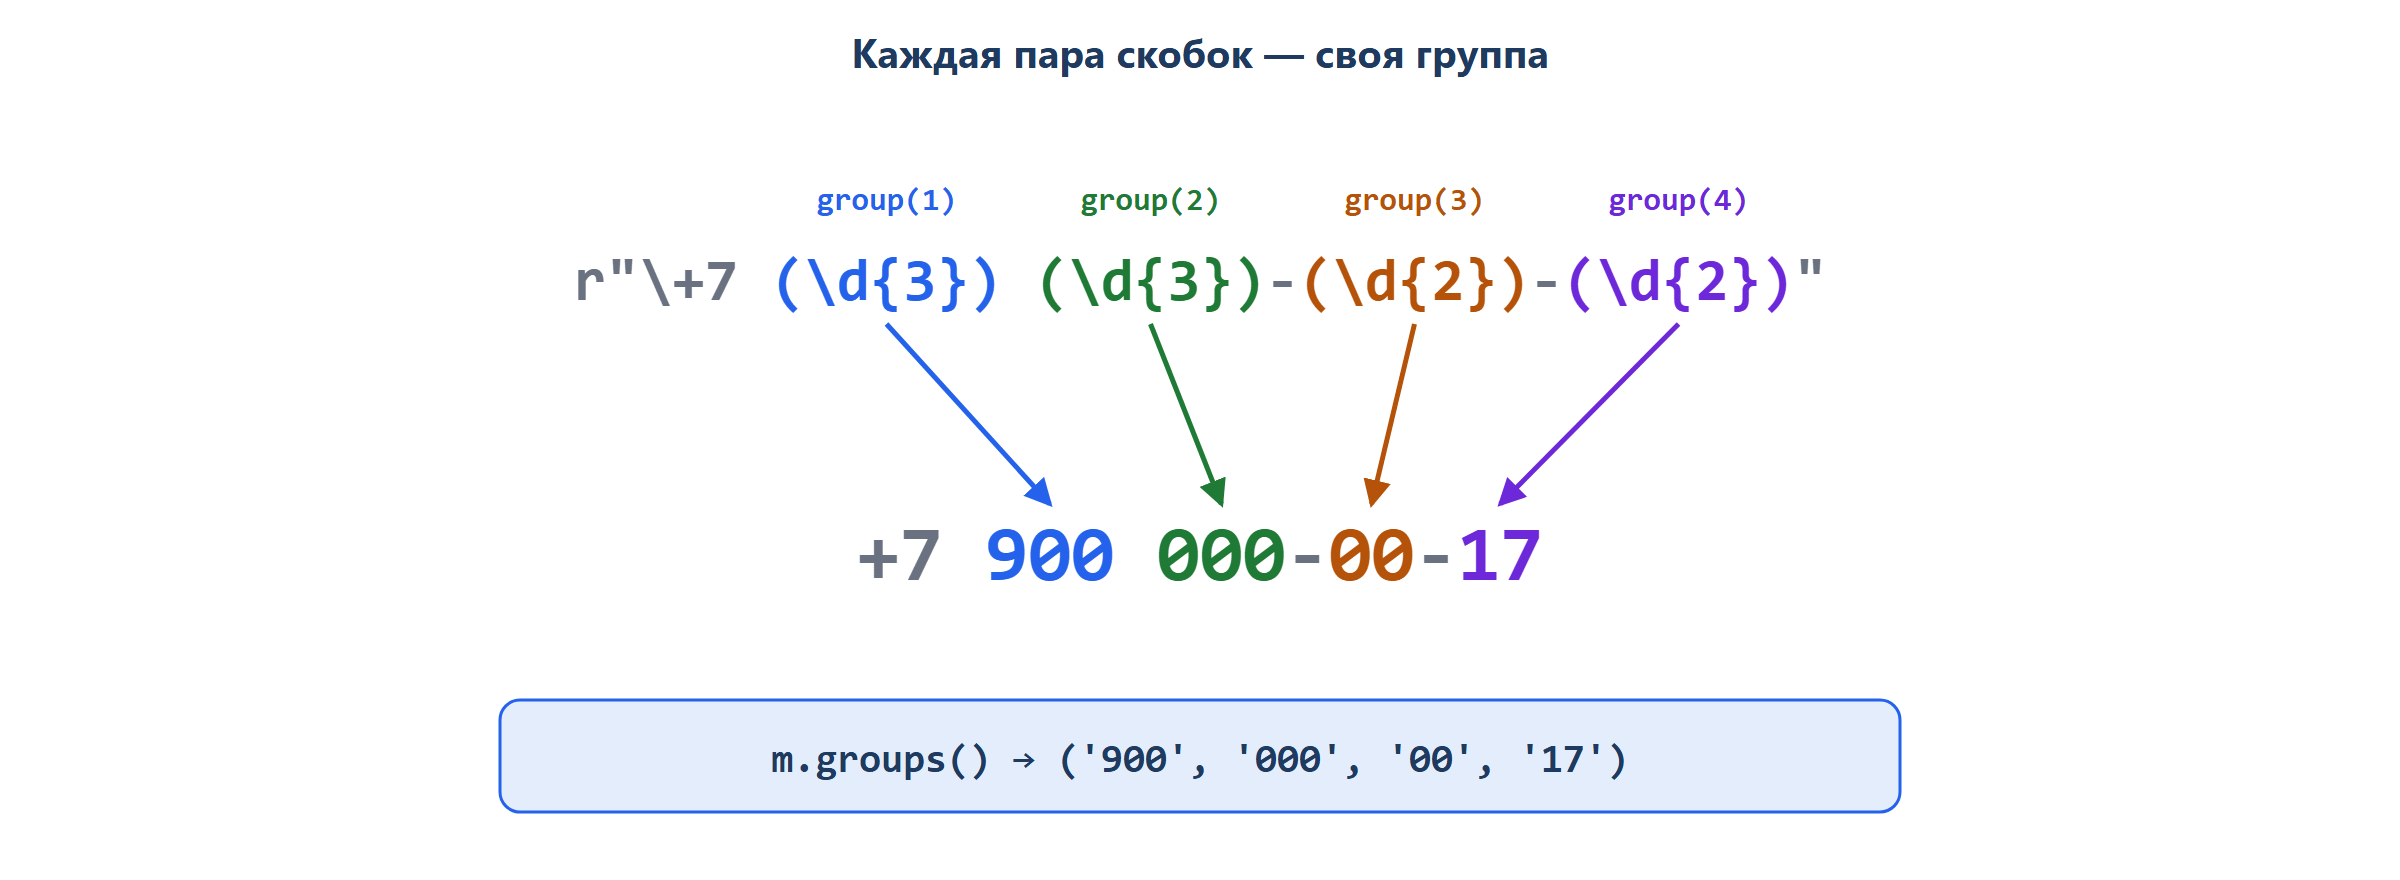
Круглые скобки в шаблоне делают группу. Совпадение ищется как обычно, но каждый кусок в скобках запоминается отдельно: m.group(1) — первая группа, m.group(2) — вторая, m.group() или m.group(0) — всё совпадение. Группы нумеруются по открывающим скобкам слева направо.
import re

text = "Менеджер: +7 900 000-00-17, звонить после 10"
m = re.search(r"\+7 (\d{3}) (\d{3})-(\d{2})-(\d{2})", text)
print(m.group())
print(m.group(1))
print(m.groups())
+7 900 000-00-17
900
('900', '000', '00', '17')Плюс в начале экранирован — \+: голый + значит «повтор». m.groups() отдаёт все группы кортежем.
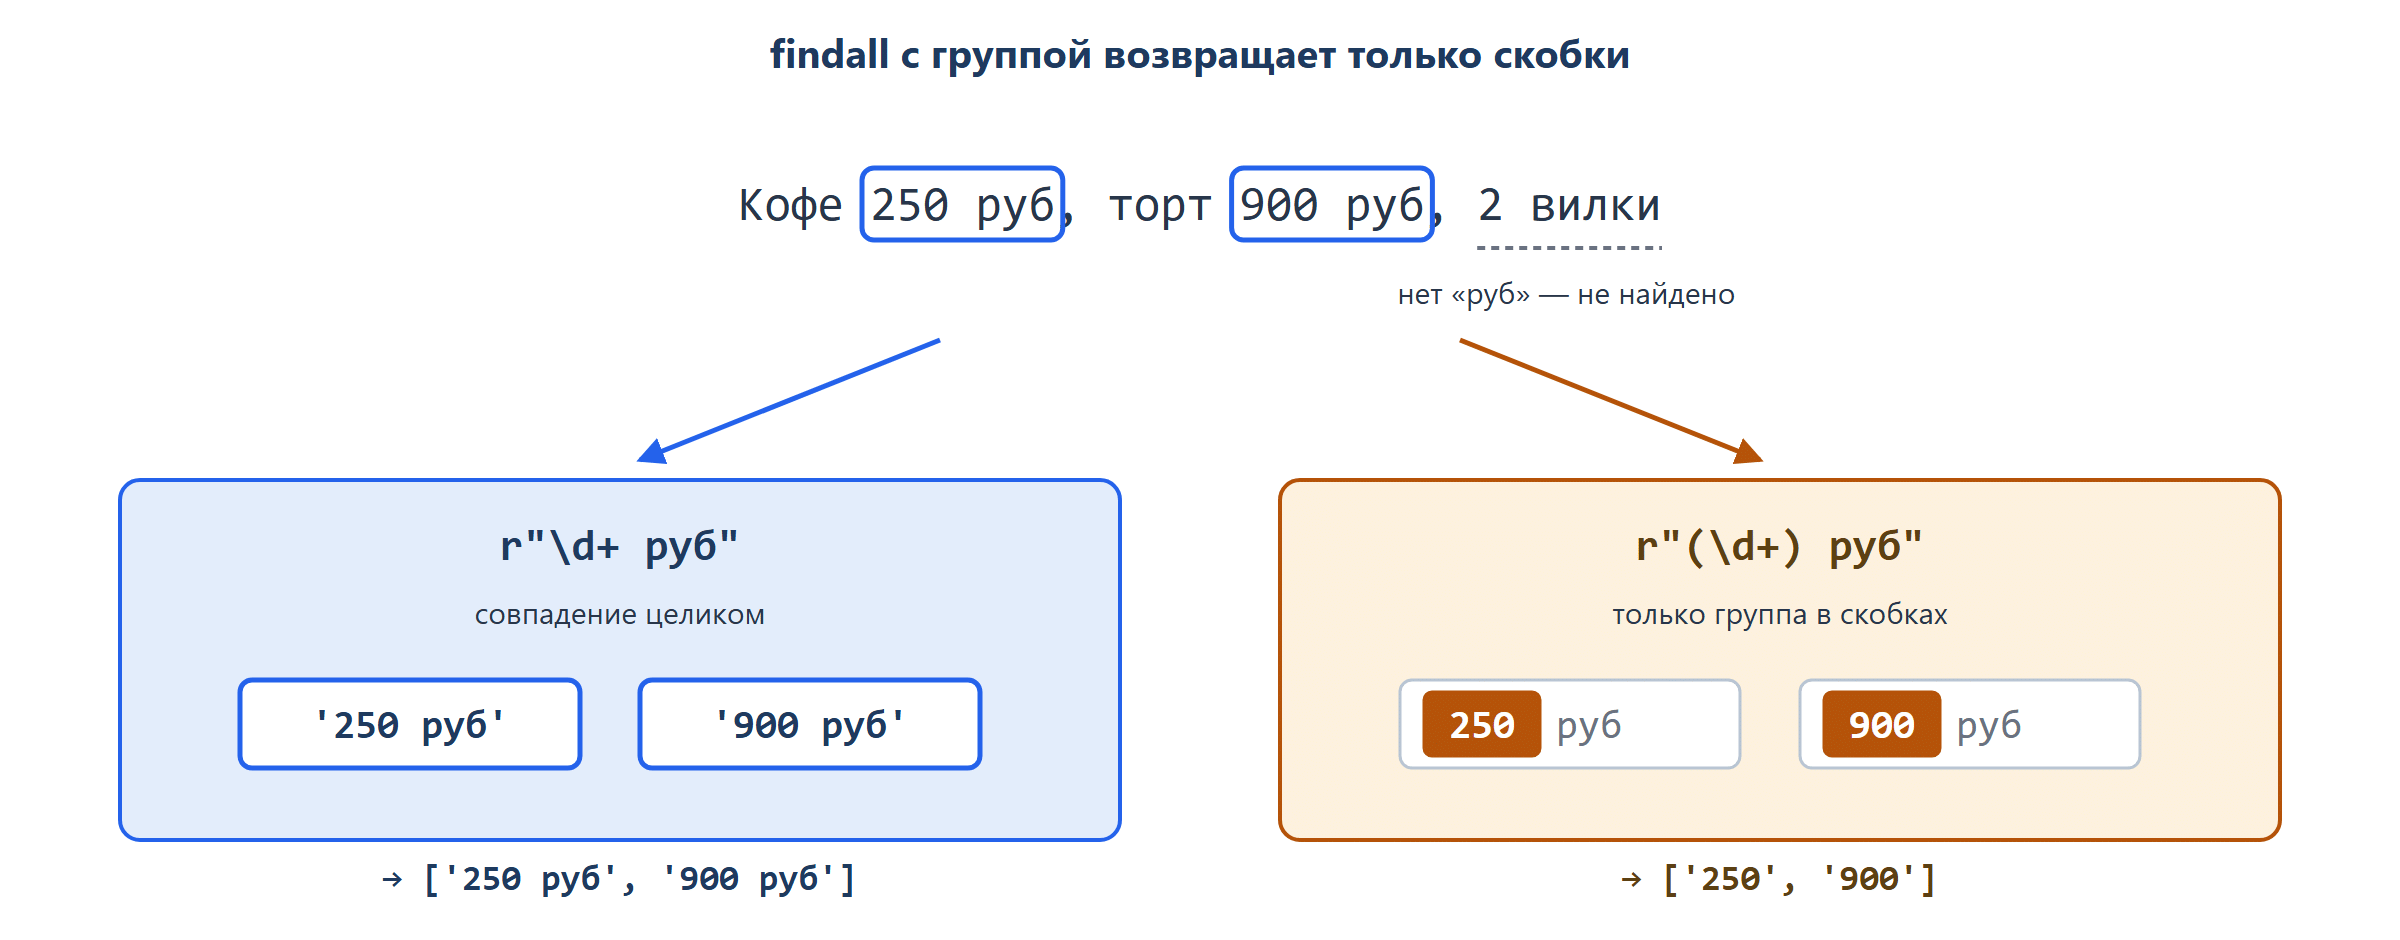
Если в шаблоне есть группы, findall возвращает не целые совпадения, а только содержимое групп. Одна группа — список строк, несколько — список кортежей. Так из текста сразу вынимается нужная часть, без хвостов вроде «руб».
import re

text = "Кофе 250 руб, торт 900 руб, 2 вилки"
print(re.findall(r"(\d+) руб", text))

mail = "Пишите: anna@example.ru или ivan.p@shop.example.com"
print(re.findall(r"([\w.]+)@([\w.]+)", mail))
['250', '900']
[('anna', 'example.ru'), ('ivan.p', 'shop.example.com')]Внутри группы знак | значит «или»: (руб|₽) — либо слово, либо значок.
import re

print(re.findall(r"(\d+) ?(руб|₽)", "Чай 300₽, пирог 450 руб, 2 вилки"))
[('300', '₽'), ('450', 'руб')]Шаблон почты тут учебный: имя из букв, цифр и точек, потом @, потом домен. Для разбора своих писем его хватает; настоящие правила адресов намного длиннее, и полностью проверить почту шаблоном не получится.
Проверьте себя
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
import re

text = "Курьер: +7 900 000-00-42"
m = re.search(r"\+7 (\d{3}) (\d{3})-(\d{2})-(\d{2})", text)
print(m.group(4))
Подсказка: Посчитайте открывающие скобки слева направо: какая часть номера попадает в группу с этим номером?
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Программа собирает домены почт из рассылки. Что она выведет? Введите число.
Исходный код для этого задания:
import re

text = ("anna@example.ru, boris@example.ru; vera@mail.example.com "
        "и ещё gleb@example.ru, dina@test.example.org")
domains = re.findall(r"[\w.]+@([\w.]+)", text)
print(len(set(domains)))
Подсказка: В список попадает только часть в скобках. Выпишите её для каждого адреса, потом уберите повторы — это делает set.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Задание. Сколько потрачено по выписке? Программа складывает только списания. Введите число.
Исходный код для этого задания:
import re

text = """Списание 450 руб. Продукты
Пополнение 3000 руб.
Списание 1200 руб. Аптека
Баланс 8350 руб.
Списание 99 руб. Подписка"""
spent = re.findall(r"Списание (\d+) руб", text)
print(sum(int(x) for x in spent))
Подсказка: Шаблон берёт числа только из строк, где перед числом слово «Списание». Остальные суммы в сложение не попадут.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Сами составьте шаблон. В тексте номера записаны двумя способами: «+7 912 345-67-89» и «8-912-345-67-89». Какой шаблон найдёт каждый номер целиком, от начала до последней цифры? Выберите вариант.
Подсказка: Проверьте каждый вариант на обеих записях по частям: как записан плюс, чем разделены части, до куда действует знак | без скобок.
Онлайн-проверка ответа появится позже
Задание. Проектная миссия «Куда ушли деньги». Банк прислал СМС-выписку за сентябрь (52 строки ниже, сохраните их в файл
vypiska.txtв кодировке UTF-8). Напишите программу: читает файл, черезre.findallс группой вынимает суммы только из списаний — и целые (450), и с копейками через запятую (450,50), — и печатает их сумму, округлённую до копеек (round(…, 2)). Суммы пополнений и балансов в итог попасть не должны. Потом проверьте программу на своих СМС. Приложите файл программы .py; в поле ответа — число.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. шаблон — сырая строка r»…», копейки в нём необязательные;
4. на строке «Пополнение» программа ничего не добавляет к итогу.21.09 Списание 1861,86 руб. Связь. Баланс 28432 руб.
02.09 Пополнение 19565 руб. Баланс 19140 руб.
28.09 Списание 3560 руб. Кафе. Баланс 6539 руб.
18.09 Списание 2900 руб. Кино. Баланс 22116 руб.
03.09 Пополнение 14211 руб. Баланс 4011 руб.
01.09 Списание 4182 руб. Одежда. Баланс 34549 руб.
04.09 Пополнение 7639 руб. Баланс 35873 руб.
29.09 Пополнение 9811 руб. Баланс 23901 руб.
14.09 Пополнение 18310 руб. Баланс 19150 руб.
06.09 Списание 322,50 руб. Кино. Баланс 38555 руб.
09.09 Списание 141,67 руб. Кино. Баланс 13523 руб.
09.09 Списание 2831,23 руб. Такси. Баланс 17541 руб.
15.09 Списание 2282 руб. Продукты. Баланс 37123 руб.
09.09 Пополнение 3963 руб. Баланс 3605 руб.
28.09 Списание 2275,97 руб. Кино. Баланс 3303 руб.
30.09 Списание 2287 руб. Такси. Баланс 1859 руб.
24.09 Баланс 15081 руб.
02.09 Списание 722,49 руб. Связь. Баланс 27902 руб.
10.09 Списание 2783 руб. Одежда. Баланс 39035 руб.
02.09 Баланс 39860 руб.
23.09 Списание 3064 руб. Кино. Баланс 8481 руб.
29.09 Списание 3894 руб. Такси. Баланс 36836 руб.
07.09 Списание 3287 руб. Одежда. Баланс 8211 руб.
28.09 Баланс 8920 руб.
17.09 Баланс 39489 руб.
04.09 Пополнение 14547 руб. Баланс 32875 руб.
06.09 Списание 3017 руб. Одежда. Баланс 26757 руб.
03.09 Пополнение 17032 руб. Баланс 3177 руб.
11.09 Списание 477,11 руб. Связь. Баланс 5314 руб.
01.09 Списание 1779,71 руб. Такси. Баланс 12220 руб.
14.09 Списание 4571 руб. Аптека. Баланс 27880 руб.
20.09 Пополнение 19744 руб. Баланс 39071 руб.
06.09 Пополнение 4817 руб. Баланс 30679 руб.
20.09 Пополнение 18362 руб. Баланс 35499 руб.
14.09 Списание 4408 руб. Аптека. Баланс 8885 руб.
28.09 Списание 584,61 руб. Такси. Баланс 23956 руб.
17.09 Списание 3734 руб. Связь. Баланс 27701 руб.
28.09 Списание 3565 руб. Одежда. Баланс 24476 руб.
27.09 Списание 3204,20 руб. Одежда. Баланс 11213 руб.
16.09 Баланс 4618 руб.
30.09 Списание 3862 руб. Такси. Баланс 8523 руб.
19.09 Баланс 9968 руб.
12.09 Списание 4172 руб. Одежда. Баланс 18798 руб.
04.09 Списание 4165,28 руб. Такси. Баланс 16897 руб.
13.09 Списание 3504,12 руб. Кино. Баланс 27862 руб.
09.09 Пополнение 5219 руб. Баланс 33382 руб.
16.09 Пополнение 7989 руб. Баланс 35304 руб.
04.09 Списание 2661,14 руб. Кафе. Баланс 36426 руб.
25.09 Списание 2896 руб. Кино. Баланс 34894 руб.
15.09 Списание 4195 руб. Продукты. Баланс 38035 руб.
06.09 Списание 1704,18 руб. Кафе. Баланс 7499 руб.
13.09 Списание 3460 руб. Продукты. Баланс 12747 руб.
Подсказка: Сумма — это цифры, потом, может быть, запятая, потом, может быть, ещё цифры: соберите это внутри одной группы из \d и знаков повтора ? и *. Группу поставьте после слова «Списание». Перед float замените запятую на точку. Проверьте шаблон сначала на трёх строках: целая сумма, сумма с копейками, пополнение.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
re.sub: заменить или скрыть
re.sub(шаблон, замена, текст) возвращает новую строку, в которой каждое совпадение заменено. Исходная строка не меняется — как у str.replace, только ищет по шаблону.
import re

text = "Карта 2200 0000 0000 1234 списала 450 руб"
print(re.sub(r"\d{4} \d{4} \d{4} ", "**** **** **** ", text))
print(re.sub(r"\s+", " ", "Итого:    450    руб"))
Карта **** **** **** 1234 списала 450 руб
Итого: 450 рубВ замене можно ссылаться на группы шаблона: \1 — что нашла первая группа, \2 — вторая. Строку замены тоже пишите сырой. Так переставляют части: дата из русской записи становится записью год-месяц-день, которую понимает сортировка и strptime из прошлого урока.
import re

text = "Оплата 05.09.2026, следующая 05.10.2026"
print(re.sub(r"(\d{2})\.(\d{2})\.(\d{4})", r"\3-\2-\1", text))
Оплата 2026-09-05, следующая 2026-10-05Проверьте себя
Задание. Что выведет программа? Введите строку так, как её напечатает Python.
Исходный код для этого задания:
import re

print(re.sub(r"\d", "*", "Код 4821"))
Подсказка: Шаблон — одна цифра, и sub заменяет каждое совпадение, а не только первое.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Задание. Программа прячет номера телефонов в отзыве, оставляя последние две цифры. Что она выведет? Введите строку так, как её напечатает Python.
Исходный код для этого задания:
import re

text = "Звоните +7 900 000-00-15 или +7 900 000-00-73"
print(re.sub(r"\+7 \d{3} \d{3}-\d{2}-(\d{2})", r"+7 XXX XXX-XX-\1", text))
Подсказка: В замене \1 подставляет то, что поймала группа в скобках. Всё остальное совпадение заменяется текстом замены.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
Онлайн-проверка ответа появится позже
Задание. Проектная миссия «Чистая записная книжка». Выгрузка рабочего чата (48 строк ниже, сохраните в
chat.txt, UTF-8). Номера в ней выдуманные, но записаны вразнобой:+7 900 000-00-15,8 900 000-00-15,+7(900)000-00-15,8-900-000-00-15— это один и тот же телефон. Напишите программу: находит все номера одним шаблоном с группами, приводит каждый к виду+79000000015(только цифры после +7) и записывает уникальные номера вcontacts.txt, по одному в строке. В поле ответа — сколько разных телефонов в чате. Приложите файл программы .py; в поле ответа — число.Принято, если:
1. введённое число совпадает с эталоном;
2. приложен файл .py, который это число выдаёт на данных из условия;Самопроверка перед сдачей (преподаватель смотрит на занятии):
3. один шаблон ловит все четыре записи номера;
4. время встреч (10:00, 14:00) и номера кабинетов в контакты не попали.Нина: мой номер +7(977)644-31-44
Жанна: мой номер 8 951 515-90-15
Мила: встреча в 14:00, кабинет 385
Егор: пишите на егор1@example.ru
Илья: мой номер +7 926 908-18-28
Егор: мой номер +7 977 644-31-44
Вера: встреча в 14:00, кабинет 358
Егор: мой номер +7(951)941-12-42
Лев: мой номер +7(912)791-49-15
Олег: мой номер +7(912)791-49-15
Лев: мой номер +7(926)908-18-28
Егор: пишите на егор2@example.ru
Кира: мой номер +7 977 526-77-11
Кира: встреча в 10:00, кабинет 203
Илья: мой номер +7 912 728-78-06
Глеб: встреча в 10:00, кабинет 335
Вера: мой номер 8-951-988-84-42
Егор: мой номер +7 900 617-45-62
Вера: мой номер 8-900-680-45-42
Дина: мой номер +7(951)989-75-62
Анна: мой номер +7 912 728-78-06
Мила: мой номер 8 977 829-92-15
Егор: мой номер +7 977 526-77-11
Жанна: мой номер +7 951 127-15-76
Мила: мой номер +7(977)202-35-97
Дина: мой номер 8 926 869-54-44
Нина: мой номер +7 900 617-45-62
Илья: мой номер +7(951)988-84-42
Мила: мой номер +7 951 127-15-76
Анна: мой номер +7 912 728-78-06
Лев: пишите на лев6@example.ru
Егор: встреча в 10:00, кабинет 311
Анна: мой номер +7(951)515-90-15
Вера: мой номер +7 926 908-18-28
Вера: мой номер 8-900-680-45-42
Кира: мой номер +7(951)987-20-76
Дина: мой номер +7(926)178-58-06
Вера: пишите на вера2@example.ru
Вера: мой номер 8-951-147-41-28
Анна: пишите на анна3@example.ru
Илья: мой номер +7 912 728-78-06
Егор: мой номер 8 926 869-54-44
Егор: мой номер 8 912 791-49-15
Вера: встреча в 14:00, кабинет 260
Вера: пишите на вера8@example.ru
Анна: встреча в 10:00, кабинет 247
Дина: пишите на дина2@example.ru
Жанна: пишите на жанна1@example.ru
Подсказка: Начало номера — «+7» или «8»: это выбор из двух вариантов, вспомните знак | внутри группы. Скобки и дефисы между частями необязательны — вспомните знак ?. Повторы убирает set.
✅ Готово, если: ответ раскрывает то, что просит критерий приёмки в задании выше.
Онлайн-проверка ответа появится позже
Границы и регистр: ^, $, \b и re.IGNORECASE
Последние метасимволы не съедают символов, а отмечают место:
^— начало строки,$— конец строки (не путайте с^внутри[ ]);\b— граница слова: место между символом слова и не-словом (пробелом, знаком, краем строки).
^ и $ вместе проверяют, что строка целиком подходит под шаблон, — удобно для проверки ввода: почтовый индекс, код из СМС.
import re

for s in ["420111", "индекс 420111", "4201"]:
    print(s, bool(re.search(r"^\d{6}$", s)))
420111 True
индекс 420111 False
4201 FalseФлаг re.IGNORECASE (короче re.I) — последний аргумент функции — отключает различие заглавных и строчных букв.
import re

text = "Кот, котлета и ещё один кот."
print(re.findall(r"кот", text))
print(re.findall(r"\bкот\b", text, re.IGNORECASE))
['кот', 'кот']
['Кот', 'кот']Без границ шаблон кот нашёл кусок внутри «котлеты» и пропустил «Кот» с заглавной. С \b и флагом — ровно два отдельных слова.
Проверьте себя
Задание. Что выведет программа? Введите число.
Исходный код для этого задания:
import re

text = "Чек. ЧЕК на 450 руб, чековая лента, чек"
print(len(re.findall(r"\bчек\b", text, re.IGNORECASE)))
Подсказка: Флаг уравнивает регистр, а \b требует, чтобы слово не продолжалось буквами. Проверьте каждое вхождение по отдельности.
✅ Готово, если: ты ввёл(а) верный ответ, и онлайн-проверка его приняла.
Онлайн-проверка ответа появится позже
Контрольный вопрос. Программа проверяет код из СМС: строка должна состоять ровно из четырёх цифр, без других символов. Какой шаблон вставить в re.search? Выберите вариант.
Исходный код для этого задания:
import re code = input("Код из СМС: ") if re.search(____, code): print("Код принят") else: print("Нужно ровно 4 цифры")Подсказка: Где стоит ^: снаружи квадратных скобок или внутри? И ограничивает ли шаблон длину кода?
Онлайн-проверка ответа появится позже
Что дальше
Теперь вы умеете составлять шаблон из метасимволов, вынимать из текста все суммы, телефоны и почты через findall, разбирать совпадение на части группами и прятать или переставлять куски через sub. В следующем уроке берёмся за большие файлы: выписка на миллион строк не влезет в память целиком — прочитаем её построчно генератором и прогоним через те же шаблоны.
← Назад · ↑ В начало урока · ⌂ К навигатору курса · Вперёд →