Во вторник владелец «Кодиума» узнаёт от ученика на пробном занятии: «А в соседней школе Python сейчас со скидкой». Скидка идёт уже вторую неделю. Владелец не видел её, потому что смотреть пять сайтов конкурентов каждое утро ему некогда. Таких вещей бизнес пропускает много: новая цена, новый поток, новый курс. В этом паттерне мы соберём для «Кодиума» утреннюю сводку, которая сама обходит сайты конкурентов и пишет владельцу в Telegram, что изменилось.
Чему научишься в этом уроке:
• объяснять заказчику, за что он платит в мониторинге;
• видеть границы: что собирать можно, а за что можно получить претензию;
• читать robots.txt сайта и находить в нём запреты;
• выбирать источники так, чтобы не собирать персональные данные.
Что такое мониторинг
Представь тайного покупателя, который каждое утро проходит мимо витрин пяти соседних магазинов и записывает ценники. Если что-то поменялось, он звонит хозяину и коротко рассказывает. Мониторинг делает то же самое, только витрины это страницы сайтов, а тайный покупатель это программа на твоём сервере.
Программу, которая открывает страницу и достаёт из неё нужные кусочки, называют сборщиком или парсером (от английского parse, разбирать). Сам сбор данных со страниц называют парсингом. Ценность для заказчика не в том, что программа умеет читать страницы. Ценность в том, что владелец перестаёт пропускать важное и не тратит на это утро.
Что получит «Кодиум»
Сквозной кейс паттерна такой. Раз в сутки, в 8:00 по Москве, программа на том же сервере, где живёт бот, открывает по одной странице курса Python у пяти школ: Skillbox, Нетология, Яндекс Практикум, Хекслет, Stepik. Со страницы берёт название, цену, платёж в месяц, длительность и ближайший старт. Сохраняет снимок дня. Сравнивает со вчерашним. Если что-то поменялось, языковая модель через CloseRouter пишет пару строк, что это значит для «Кодиума», и сводка уходит владельцу в Telegram тем же ботом. Если ничего не поменялось, приходит короткое «Конкуренты: без изменений».
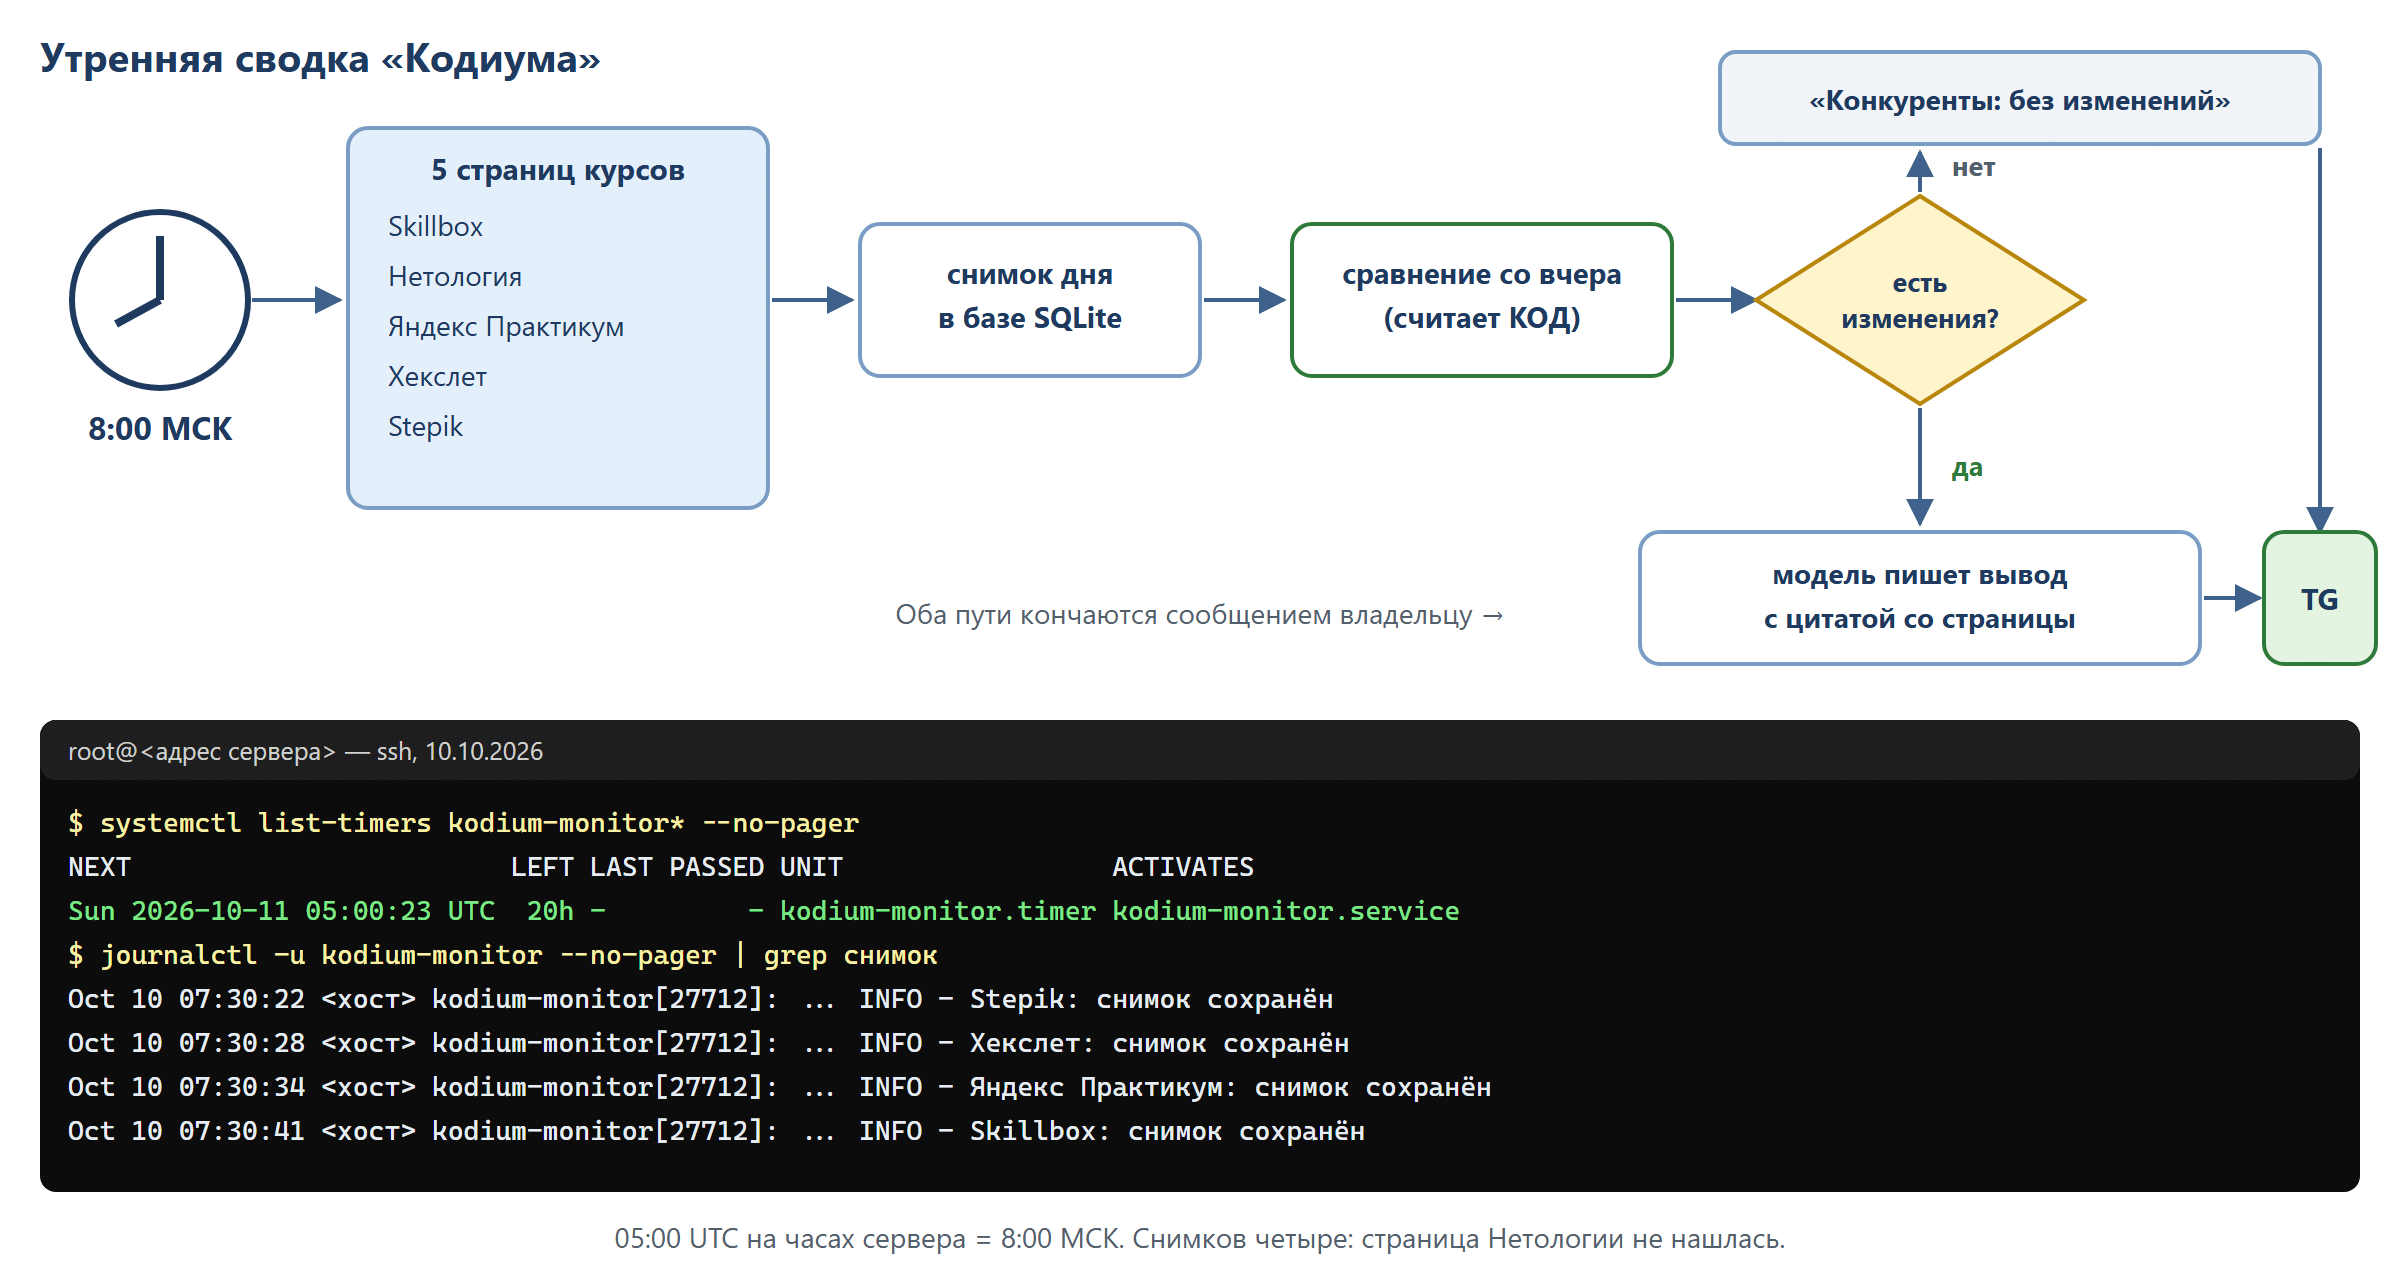
Это прогнано руками в курсе. И главное, что показал прогон: сборщик ошибается уверенно. Он может подставить телефон вместо даты старта и отчитаться «всё проверено». Поэтому половина паттерна будет про то, как проверять собранное. Сводка с ложными цифрами хуже, чем никакой: владелец примет решение по неправде.
Где граница: что важно знать
Это не юридическая консультация. Для заказчика с серьёзным объёмом сбора нужен юрист. Ниже то, что стоит знать, чтобы не наделать ошибок на старте.
Отдельного закона «о парсинге» в России нет. Риски идут от трёх вещей.
- Право на базу данных. Статья 1334 ГК РФ защищает того, кто собрал базу: нельзя без разрешения извлекать из неё материалы и использовать их дальше. Где проходит граница «существенной части», суды пока не определили. Поэтому правило курса такое: берём несколько страниц в сутки, а не выкачиваем каталог сайта.
- Персональные данные. 152-ФЗ: если данные лежат в открытом доступе, это ещё не разрешение их обрабатывать (для данных, которые человек сам открыл для всех, есть отдельные условия в статье 10.1). Имена, телефоны, отзывы с подписями мы не собираем и не храним.
- Условия сайта. Пользовательское соглашение сайта считается договором с тобой. Если там запрещён автоматический сбор, это аргумент против тебя.
Самое известное дело в этой теме: «ВКонтакте» против компании «Дабл» (А40-18827/2017). По материалам pravo.ru, Суд по интеллектуальным правам в 2018 году сказал: если база служит основным ресурсом сайта и в ней больше 10 000 пользователей, затраты на неё предполагаются, а спорить приходится о том, существенную ли часть извлекли. Сама статья 1334 называет такой же порог: не меньше десяти тысяч элементов. Дело ходило по судам несколько лет (новость о возврате на пересмотр) и в 2022 году закончилось мировым соглашением, так что окончательной позиции суда по существу нет. Общий обзор этики сбора и robots.txt на примерах зарубежных дел есть в статье на сайте: обзор этики и robots.txt.
robots.txt: правила вежливости сайта
У большинства сайтов есть файл robots.txt по адресу https://<сайт>/robots.txt. Это табличка на двери: «сюда роботам можно, сюда нельзя». Закон его не требует соблюдать, но если ты табличку нарушил или обошёл защиту сайта, суды и площадки читают это против тебя. В курсе правило простое: берём только то, что robots.txt разрешает. Если сайт в ответ показывает ошибку 403, капчу или вопрос «вы робот?», это защита сайта: не обходим её, а меняем источник или спрашиваем заказчика.
Строка Disallow: /profile/ значит «в раздел /profile/ не ходить». Звёздочка * означает «любые символы». Вот что нашлось в robots.txt пяти школ 10.10.2026:
- Skillbox: страницы курсов разрешены; закрыты служебные разделы, вход, личный кабинет, поиск.
- Нетология: страницы программ разрешены; закрыты вход, PDF программ, адреса с
ref=. - Яндекс Практикум: в его robots.txt закрыт
/*?*, то есть любой адрес со знаком вопроса. Страница курса без «?» разрешена, та же страница с меткой вроде?utm=1уже нет. Закрыт и личный кабинет/profile/. - Хекслет: страницы программ разрешены, а страница с ценами
/pricingзакрыта. - Stepik: страницы курсов
/course/<номер>/promoразрешены, а отзывы курсов и оплата закрыты.
Посмотри на Хекслет и Stepik внимательно: цены и отзывы, самое интересное для мониторинга, там как раз закрыты. Значит, их не берём. Хочется знать, что пишут ученики конкурентов? Есть открытые ленты их Telegram-каналов, так делали в треке 3: урок 4.2 трека 3 про анализ конкурентов.
Правила курса для сбора
- только открытые страницы без входа на сайт;
- только то, что разрешает robots.txt;
- свой User-Agent (подпись программы) с контактом владельца, чтобы сайт видел, кто к нему пришёл;
- пауза несколько секунд между запросами, несколько страниц раз в сутки;
- никаких персональных данных.
Под эти правила кейс «Кодиума» подходит: пять запросов в сутки к разрешённым страницам, без входа и обхода защиты, без персональных данных.
Кейс из жизни: заказчик просит «собирать отзывы о нас со всех площадок с именами, чтобы отвечать каждому». Имена это персональные данные, а отзывы на части площадок закрыты в robots.txt. Предложи вместо этого сводку по открытым лентам без имён: что хвалят, на что жалуются, с цитатой.
Контрольный вопрос. Ты открыл robots.txt Яндекс Практикума и видишь
Disallow: /*?*. Какой адрес можно брать в сборщик?Подсказка: Есть ли в адресе знак вопроса и не закрыт ли раздел целиком?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. Заказчик просит собирать отзывы о конкурентах вместе с именами авторов. Как поступишь?
Подсказка: Что говорит 152-ФЗ про «общедоступные» данные?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. Что продаёшь заказчику в мониторинге в первую очередь?
Подсказка: Вспомни историю со скидкой у соседней школы.
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Задание. МИССИЯ «Карта источников». 1. Возьми своего заказчика (тот же, что в П1–П2) и выпиши 3–5 его конкурентов или источников, которые ему важно видеть каждый день. 2. Для каждого найди одну открытую страницу без входа (курс, товар, прайс). 3. Открой robots.txt каждого сайта в браузере. Выпиши строки Disallow, которые касаются твоей страницы, и реши: можно или нельзя. Особое внимание строкам со звёздочкой и знаком вопроса. 4. Отметь, есть ли на странице персональные данные (имена, телефоны, отзывы с подписями). Если есть, напиши, что из неё не берёшь. Принято, если: приложена таблица «источник → адрес страницы → строки robots.txt → можно/нельзя → что не берём» минимум на 3 источника и снимок экрана robots.txt хотя бы одного сайта.
Подсказка: Если строка Disallow со звёздочкой подходит к твоему адресу, страница выпадает.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Читайте также: Мониторинг цен конкурентов с нейросетью: как сделать сводку, которой можно верить
Что дальше
Источники выбраны. В следующем уроке решим, что именно брать со страницы и как проверять, что сборщик взял правильное, а не первое похожее.
Итог:
• мониторинг экономит владельцу время и ловит изменения у конкурентов;
• риски сбора: база данных (ст. 1334 ГК РФ), персональные данные (152-ФЗ), условия сайта;
• robots.txt читаем до сбора, адреса со звёздочкой и «?» проверяем отдельно;
• у «Кодиума» пять разрешённых страниц раз в сутки без имён и без входа.