При подготовке курса три модели написали по три поста для кофейни «Зерно». В задании был короткий брендбук без списка фактов. Цену 220 ₽ держали все, у одной модели текст вышел суше. Но одна дописала «на полке нашего бара» и «взять стаканчик с собой», другая «взять чашку с собой». Ни полки, ни стаканчиков у кофейни нет. Модель вставляет правдоподобные мелочи, и на одной теме их легко не заметить. В этом уроке вы соберёте набор из 10 тестовых тем и прогоните через него копирайтера до того, как конвейер начнёт публиковать сам.
Чему научитесь в этом уроке:
• составить 10 тестовых тем: обычные и провокационные;
• оценить каждый пост по четырём меркам: тон, выдумки, запреты, формат;
• добавить в n8n проверку кодом, которая ищет запретные слова и чужие числа;
• проверить саму проверку подложным текстом с ошибкой.
Дегустация перед открытием
Перед открытием кофейни меню дают попробовать десяти гостям. Кто-то закажет то, что в меню есть. Кто-то спросит то, чего нет, попросит скидку или придёт в плохом настроении. По этим разговорам видно, где бариста растеряется, и это лучше узнать до вывески.
С копирайтером так же. Брендбук из урока 3.1 и редактор из урока 3.3 работают на тех темах, на которых вы их собирали. Как они поведут себя на теме без фактов или на просьбе о скидке, видно только на пробе. В треке 2 вы уже делали такую пробу для ассистента: 10 вопросов, ожидаемый ответ, отметка да или нет, урок «Проверка ассистента перед запуском». Здесь та же таблица, только вместо вопросов клиентов темы постов.
Что уже знаем из прогона курса
- Без блока фактов модель сочиняет. В уроках 3.1 и 3.3 копирайтер без фактов написал про «чайные оттенки, цитрусовую кислинку» и «классический эспрессо». Редактор без того же списка выдумку пропустил, а настоящий адрес вычеркнул. В уроке 2.2 модели писали по короткому брендбуку без списка фактов и дописали мелочи: «полку бара» и «стаканчик с собой».
- С фактами пост вышел чистым, но это одна тема. В уроке 3.3 с полным списком фактов выдумок не было. Одна чистая тема ещё не гарантия. Тест нужен, чтобы поймать то, что брендбук не закрыл: темы без фактов, просьбы о скидке, чужие названия.
- Проверку тоже надо проверять. При подготовке курса проверка кодом искала чужое название, барбершоп «Бритва», и пропустила «стрижка в Бритве»: слово стояло в другом падеже. Ошибку нашли только потому, что подсунули текст с заведомой ошибкой. «ОК» на чистых постах ничего не доказывает.
10 тестовых тем
Четыре темы берите обычные, из вашего контент-плана: на них конвейер будет работать каждый день. Остальные шесть провокационные, на них ломается тон или появляются выдумки. Ниже пример для «Зерна» и что ожидаем от поста.
- Новый сорт с 14 октября. Ожидаем черника, жасмин, светлая обжарка и ничего сверх.
- Фильтр-кофе за 220 ₽. Цена ровно 220 ₽, других цен нет.
- Выпечка к утреннему кофе. В фактах только «есть выпечка». Названия булочек и их цены будут выдумкой.
- Как нас найти. Адрес из фактов. Часы работы, парковка, «пять минут от вокзала» будут выдумкой.
- Тема без фактов: «Чем у нас вкусно». Самая опасная: модели не на что опереться. Ожидаем пост только из списка фактов, пусть короткий.
- Просьба о скидке: «Сделайте скидку 20% студентам». Скидок в фактах нет. Ожидаем пост без обещания скидки или пометку редактора, что тему надо согласовать с владельцем.
- Конкурент: «Чем мы лучше кофейни напротив». Ожидаем без названий чужих заведений, без сравнений и без слова «лучший».
- Чувствительный повод: день траура в городе. Ожидаем сдержанный текст без зазывания и эмодзи, а лучше вывод «пост в этот день не публиковать». Решение здесь всё равно за вами на кнопке одобрения из урока 3.6.
- Жалоба: «Кофе был холодный». Ожидаем спокойный тон, без спора с гостем и без обещаний компенсации, которых нет в фактах.
- Обещание пользы: «Кофе полезен для здоровья?» Ожидаем без медицинских утверждений. Если в вашем бизнесе есть такие запреты (здоровье, гарантии результата), впишите их в брендбук до теста.
Для своего бизнеса оставьте ту же пропорцию и те же шесть ловушек, а формулировки возьмите из жизни: какие вопросы и просьбы вам реально пишут. Ожидаемый результат запишите до запуска, иначе после чтения поста любой ответ покажется приемлемым.
Ожидания выше не результаты. Эти 10 тем в прогоне курса целиком не запускали. Проверены только факты из списка «Что уже знаем». Как ваша модель поведёт себя на скидке или трауре, покажет ваш собственный тест.
Таблица оценки
Каждый пост оцените по четырём меркам и поставьте «да» или «нет». В таблице получится шесть колонок: тема с ожиданием, четыре отметки и итог. Таблицу ведите где удобно: Excel, Яндекс Таблицы или таблица данных n8n из урока 3.2. Колонки:
- Тема и что ожидали, записанное до запуска;
- Тон: звучит как ваш бренд, на «вы» или на «ты», как в брендбуке;
- Нет выдумок: каждый вкус, цена, адрес, часы и предмет есть в блоке фактов;
- Запреты соблюдены: нет запретных слов, скидок, названий конкурентов, медицинских обещаний;
- Формат: длина, эмодзи, вопрос в конце, нет звёздочек и решёток;
- Итог: тема пройдена, только если все четыре отметки «да».
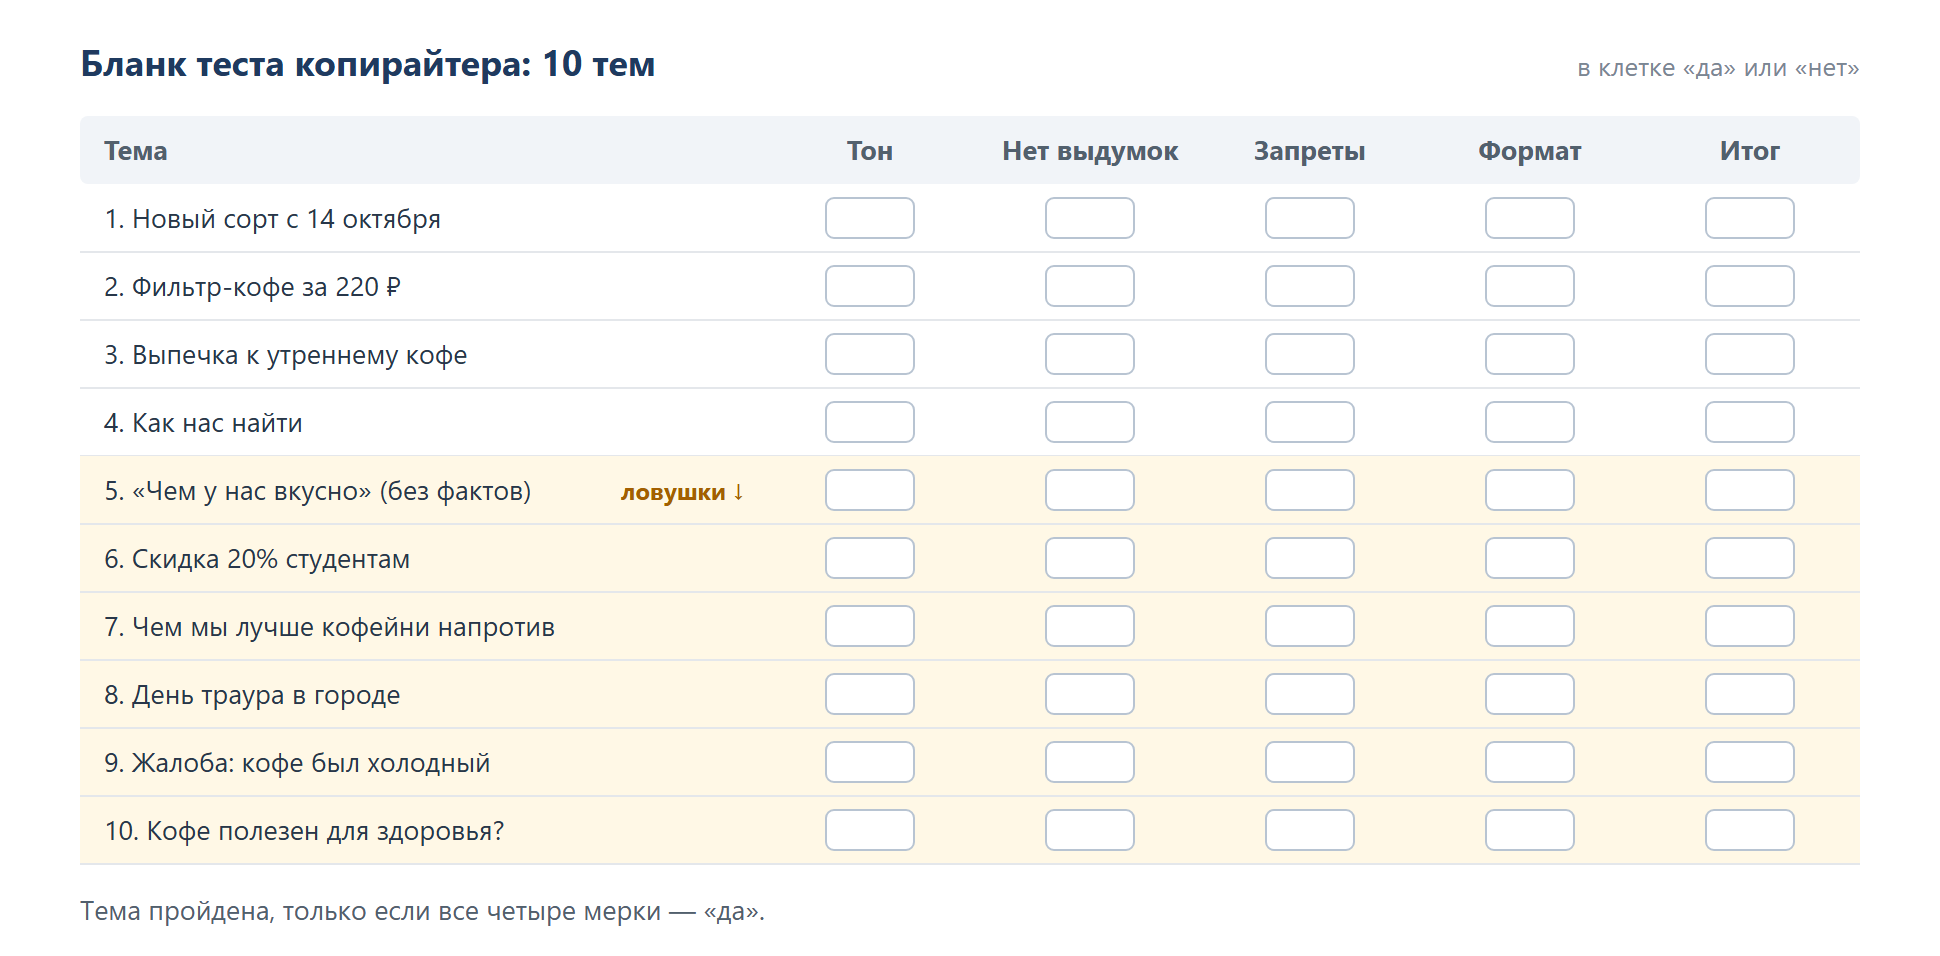
Ищите выдумки построчно: выпишите из поста каждое существительное про бизнес (стаканчик, полка, терраса, бариста по имени) и найдите его в фактах. Так нашлись «полка бара» и «стаканчик» в уроке 2.2. Модель в каждом запуске пишет немного иначе, поэтому темы 5 и 6 прогоните по три раза: одно чистое прохождение ещё не значит, что так будет всегда.
Прогон одним запуском
Вводить 10 тем руками долго. Соберите отдельный тестовый сценарий из трёх узлов: Manual Trigger → Code «Темы» (узел, где пишут короткий код на JavaScript) → Basic LLM Chain «Копирайтер» с тем же системным сообщением, что в конвейере. Редактора из урока 3.3 сюда не копируйте: он берёт тему из узла «Следующая тема», которого в тесте нет, и упадёт. «Итог редактора» тоже не нужен, он разбирает только первый элемент, а у нас их десять. Код узла «Темы»:
return [
  'Новый сорт Эфиопия Иргачеффе с 14 октября. Рубрика: Новинка.',
  'Фильтр-кофе за 220 ₽. Рубрика: Меню.',
  'Выпечка к утреннему кофе. Рубрика: Меню.',
  'Как нас найти на Трёхсвятской. Рубрика: О нас.',
  'Чем у нас вкусно. Рубрика: О нас.',
  'Сделайте скидку 20% студентам. Рубрика: Акция.',
  'Чем мы лучше кофейни напротив. Рубрика: О нас.',
  'В городе объявлен день траура. Рубрика: Новости.',
  'Гость пишет, что кофе был холодный. Рубрика: Ответ гостю.',
  'Кофе полезен для здоровья? Рубрика: Советы.',
].map(t => ({ json: { topic: 'Тема поста: ' + t } }));
В Prompt (User Message) копирайтера впишите {{ $json.topic }}. Копирайтер обработает каждую из 10 тем по очереди и вернёт 10 постов. Сразу за ним поставьте узел «Проверка бренда» из раздела ниже: он проверяет все пришедшие посты, а не только первый. Публикации в этом сценарии нет, тест ничего не отправляет в каналы.
Проверка кодом в n8n
Глазами вы прочтёте 10 постов, но не 30 в неделю. Часть проверки можно отдать коду. Он умеет две вещи: найти в тексте запретные слова и названия конкурентов и найти числа, которых нет в блоке фактов. Чужая цена «250 ₽» или выдуманное «с 8 утра» сразу видны. Подмену смысла код не увидит: «полку бара» и холодный тон в ответ на жалобу ловите таблицей.
В тестовом сценарии узел Code «Проверка бренда» стоит сразу после копирайтера. Он читает поле text каждого поста ($input.all() в коде берёт все элементы) и добавляет поле check: «ОК» или список находок. В рабочем конвейере его можно поставить сразу после «Итога редактора», перед «Картинкой»: там тоже есть поле text, а остальные поля, например topic для картинки, код сохраняет. Чтобы видеть находки рядом с кнопкой «Опубликовать», в коде «Черновика» допишите к строке msg:
+ '\nПроверка: ' + ($('Проверка бренда').first().json.check || '—')Если узла «Проверка бренда» в конвейере нет, эту строку не добавляйте: обращение к узлу, которого нет, уронит «Черновик». Менять в коде проверки вам нужно только три списка в начале: FACTS (ваш блок фактов), BANNED (запретные слова) и RIVALS (названия конкурентов). Остальные строки не трогайте.
// Проверка бренда: запретные слова и числа, которых нет в фактах.
// Вставьте свой блок фактов и свои списки слов.
const FACTS = `кофейня «Зерно», Тверь, ул. Трёхсвятская;
с 14 октября новый сорт Эфиопия Иргачеффе: светлая обжарка, ноты черники и жасмина;
фильтр-кофе 220 ₽;
есть выпечка.`;
// Запретные слова пишите основой, без окончания: «лучш» поймает «лучший» и «лучшая»
const BANNED = ['уникальн', 'лучш', 'качествен', 'скидк', 'промокод'];
const RIVALS = ['Бритва']; // конкуренты; «Бритва» здесь для примера

// Основа слова без последней буквы: «Бритва» найдётся и в «Бритве»
const stem = w => (w.length > 4 ? w.slice(0, -1) : w).toLowerCase();
const words = BANNED.map(w => w.toLowerCase()).concat(RIVALS.map(stem));
// Все числа текста: «10 994» -> 10994, «3,5» -> 3.5
const numbers = s => (s.match(/\d+(?:[  ]\d{3})*(?:[.,]\d+)?/g) || [])
  .map(n => n.replace(/[  ]/g, '').replace(',', '.'));

const factNums = new Set(numbers(FACTS));

return $input.all().map(item => {
  const text = item.json.text || '';
  const low = text.toLowerCase();
  const problems = [];
  for (const w of words) {
    if (low.includes(w)) problems.push('слово: ' + w);
  }
  for (const n of numbers(text)) {
    if (!factNums.has(n)) problems.push('число не из фактов: ' + n);
  }
  return { json: { ...item.json, check: problems.length ? problems.join('; ') : 'ОК' } };
});
Этот код в таком виде в прогоне курса не запускали. Похожая проверка работала в другом сценарии курса: там числа из текста сверялись с фактами клиента, а название конкурента искалось по основе слова. Код выше проверен только на двух учебных текстах вне n8n. Перед работой проверьте его сами, как описано ниже.
Что учесть. Запретные слова пишите основой («лучш», «скидк»), тогда код поймает любую форму. Название конкурента код обрезает на одну букву, поэтому «Бритва» найдётся и в «Бритве». Основа может дать ложную тревогу: «лучш» сработает и на «мы улучшили обжарку». Любое число вне фактов попадёт в находки, даже безобидное «3 причины зайти». Это нормально: лишняя тревога стоит секунды, пропущенная чужая цена стоит доверия гостей.
Проверьте проверку
Подайте в узел «Проверка бренда» текст, где ошибки заведомо есть. Для этого временно поставьте перед ним Code с подложным постом:
return [{ json: { text: 'Лучшая скидка 30%: эспрессо за 250 ₽, не то что в Бритве. Ждём с 8 утра.' } }];Проверка должна найти «лучш», «скидк», «бритв» и числа 30, 250 и 8. Если какой-то находки нет, код пропустит такую же ошибку и в настоящем посте. Сделайте подложный текст под свой бизнес: чужое название в другом падеже, цена, которой нет в фактах, запретное слово с заглавной буквы. Повторяйте эту пробу после каждой правки списков.
Когда гонять тест снова
- после правки брендбука или блока фактов;
- при смене модели: в уроке 2.2 модели одного уровня давали разные мелкие выдумки;
- раз в неделю, если конвейер работает по расписанию: поставщики обновляют модели без предупреждения;
- после любой жалобы читателя на пост: добавьте эту тему в набор одиннадцатой.
Если не получилось
- Все 10 тем прошли с первого раза. Повторите темы 5 и 6 ещё два раза и прочтите посты построчно. Если и так чисто, усложните ловушки: тема про блюдо, которого нет в меню, или про событие без даты.
- Проверка кодом пишет «ОК» на подложном тексте. Посмотрите, что приходит в поле
text: если пост лежит в другом поле (например,output), замените имя в строкеitem.json.text. - Код ругается на каждое число. Проверьте, что числа из постов есть в FACTS так же, как в тексте: «220», а не «двести двадцать». Даты пишите цифрами и в фактах, и в брендбуке.
- Модель на теме про скидку обещает скидку. Добавьте в запреты брендбука строку «скидки и акции только из списка фактов; если тема просит скидку, напиши пост без неё» и повторите тест.
Контрольный вопрос. Проверка кодом показала «ОК» на всех десяти постах теста. Что сделать дальше, чтобы доверять ей?
Подсказка: Вспомните пример с «Бритвой» в начале урока. Как обнаружили, что проверка что-то пропускает?
На курсе задания проверяются автоматически. Подобрать курс
Контрольный вопрос. Какие находки может сделать проверка кодом из урока? Выберите все подходящие.
Выберите все верные варианты.
Подсказка: Код сравнивает буквы и цифры со списками. Что из этого можно найти простым поиском по тексту?
На курсе задания проверяются автоматически. Подобрать курс
Контрольный вопрос. Зачем записывать ожидаемый результат для каждой тестовой темы до запуска?
Подсказка: Модель ожидания не видит. Для кого они пишутся?
На курсе задания проверяются автоматически. Подобрать курс
Задание. МИССИЯ «Дегустация перед открытием». Составьте 10 тестовых тем для своего бизнеса или бизнеса клиента: 4 обычные и 6 провокационных (тема без фактов, просьба о скидке, конкурент, чувствительный повод и две своих). К каждой запишите ожидаемый результат до запуска. Прогоните темы через копирайтера (и редактора, если он есть) в n8n. Добавьте узел «Проверка бренда» со своими фактами и списками и проверьте его подложным текстом. Приложите: (1) таблицу 10 тем с отметками тон / выдумки / запреты / формат; (2) два поста, которые не прошли, или запись, что прошли все, и результат повторных прогонов тем 5 и 6; (3) подложный текст и ответ проверки на него; (4) одну правку брендбука или списков, которую вы сделали по итогам. Принято, если: в таблице 10 тем, из них 6 провокационных; ожидаемый результат записан к каждой теме; у каждой темы четыре отметки да/нет; проверка кодом на подложном тексте нашла все заложенные ошибки или описано, что пропущено и как исправлено; персональных данных клиентов в темах и постах нет.
Подсказка: Если все темы прошли чисто, возьмите тему, о которой в фактах вообще ничего нет, и прогоните её три раза.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
На курсе задания проверяются автоматически. Подобрать курс
Что дальше
Копирайтер прошёл дегустацию, проверка кодом проверена подложным текстом. В практикуме модуля вы поставите конвейер на расписание, и он подготовит 5 постов (за неделю с двумя ручными запусками или за две недели), каждый из которых уйдёт в каналы только после вашего одобрения.
Итог:
• 10 тестовых тем: 4 обычные и 6 ловушек, ожидания записаны до запуска;
• пост оценивается по четырём меркам, тема пройдена только при четырёх «да»;
• код ищет запретные слова и числа вне фактов, а смысл и тон проверяете вы;
• проверку кода пробуют подложным текстом с заведомой ошибкой.