В прогоне курса агент собрал сборщик за 7,7 минуты, тесты прошли 13 из 13, отчёт выглядел аккуратно. Потом оказалось, что три адреса из пяти он придумал, и они отвечают 404 (страница не найдена). Понадобилось ещё четыре задания, чтобы данные стали правдой. Пройдём этот путь и научимся ловить такие ошибки до владельца.
Чему научишься в этом уроке:
• поставить агенту задачу на сборщик с правилами сбора;
• проверять robots.txt библиотекой, которая понимает звёздочку;
• ловить уверенную неправду в собранных данных;
• следить за числом тестов и возвращать удалённые.
Подготовка и грабля с robots.txt
Создай новую папку проекта, например monitoring-kodium, и открой в ней Claude Code так же, как в П1 и П2. Ключ CloseRouter и токен бота пойдут в .env этого проекта, как ты делал в уроке 1.6.
Одна ловушка спрятана ещё до сбора. В Python есть стандартная проверка robots.txt, urllib.robotparser. При подготовке курса её проверили на настоящих файлах, и она ответила «можно» для двух запрещённых адресов: страницы Практикума с ?utm=1 и отзывов Stepik. Она не понимает звёздочку в середине правила. Поэтому в задании прямо названа библиотека protego, которая звёздочки понимает. Если агент предложит robotparser, верни его к protego.
Шаг 1. Задание на сборщик
Задание из прогона, его можно отдать агенту как есть:
Новый проект для «Кодиума» (паттерн «Мониторинг»): каждое утро владелец получает в Telegram короткую сводку, что изменилось у конкурентов.
Сделай в этой папке (виртуальное окружение .venv создай сам, свежие версии библиотек, на Windows добавь tzdata):
1. Список из 5 страниц курсов Python у школ: Skillbox, Нетология, Яндекс Практикум, Хекслет, Stepik — найди по одной публичной странице курса Python у каждой (без входа на сайт). Сначала проверь robots.txt каждого сайта библиотекой, которая понимает символ * в правилах (protego), и не бери адреса с «?», /pricing и отзывы. Запросы — со своим User-Agent «KodiumMonitor/0.1 (+контакт владельца)», пауза 5–10 секунд между сайтами, таймаут, без повторов чаще раза в сутки.
2. Со страницы бери: название курса, цену (если она есть в HTML), длительность, ближайший старт. Если данные подгружаются скриптом и в HTML их нет — так и запиши «нет в HTML», не выдумывай.
3. Храни снимки по дням в SQLite (snapshots.db). Изменения со вчера считает КОД, не модель.
4. Если изменений нет — в Telegram короткое «Конкуренты: без изменений». Если есть — модель через CloseRouter (ключ CLOSEROUTER_API_KEY в .env, адрес https://api.closerouter.dev/v1, основная модель google/gemini-3.6-flash, запасная openai/gpt-5.4-mini) пишет 5–7 строк «что это значит для Кодиума», к каждому выводу — цитата из снимка. Повторы: таймаут, 2 попытки, потом запасная модель, потом сообщение «разбор не удался» с сырыми изменениями.
5. Токен бота и ключ не должны попадать в журнал (httpx/httpcore — уровень WARNING).
Тесты на сравнение снимков и разбор robots (подмена сети и модели). Запусти тесты, затем ОДИН настоящий прогон сбора (без модели, если изменений нет — первый день изменений нет) и покажи, что удалось собрать с каждого сайта.
Обрати внимание на пункт 2: «не выдумывай». И на просьбу в конце показать, что собрано с каждого сайта. Без неё ты увидел бы только «тесты прошли». Агент работал 7,7 минуты: тесты 13 из 13, но три адреса из пяти придуманные, а у Stepik в дату старта попал текст кнопки «Начать просмотр».
Почему тесты прошли, если адреса неверные? Тесты подменяют сеть сохранённой страницей и проверяют логику. Существует ли адрес на самом деле, они не знают. Проверка правды это настоящий сбор и твои глаза.
Задание шага 1 для своего заказчика
Задание выше написано под «Кодиум». Для своего заказчика возьми ту же основу и замени только места в угловых скобках: <заказчик>, <источники> (сайты и страницы из миссии урока 4.1) и <что сравниваем> (поля и правила из миссии урока 4.2). Если оставить «курсы Python» и «ближайший старт», сборщик будет искать старт курса на странице шиномонтажа.
Новый проект для «<заказчик>» (паттерн «Мониторинг»): каждое утро владелец получает в Telegram короткую сводку, что изменилось у <кого: конкурентов, поставщиков, площадок>.
Сделай в этой папке (виртуальное окружение .venv создай сам, свежие версии библиотек, на Windows добавь tzdata):
1. Источники: <список сайтов и по одной странице на каждый: адрес или «найди страницу <что за страница> у <сайт>»>. Сначала проверь robots.txt каждого сайта библиотекой, которая понимает символ * в правилах (protego), и не бери адреса с «?» и закрытые разделы. Запросы — со своим User-Agent «<Имя>Monitor/0.1 (+контакт владельца)», пауза 5–10 секунд между сайтами, таймаут, без входа на сайт, без повторов чаще раза в сутки.
2. Со страницы бери: <что сравниваем: поля и правило для каждого — откуда брать, откуда нельзя>. Если данных в HTML нет — так и запиши «нет в HTML», не выдумывай. Персональные данные (имена, телефоны) не сохраняй.
3. Храни снимки по дням в SQLite (snapshots.db). Изменения со вчера считает КОД, не модель.
4. Если изменений нет — в Telegram короткое «<Источники>: без изменений». Если есть — модель через CloseRouter (ключ CLOSEROUTER_API_KEY в .env, адрес https://api.closerouter.dev/v1, основная и запасная модели в .env: MODEL_MAIN, MODEL_FALLBACK) пишет 5–7 строк «что это значит для <заказчик>», к каждому выводу — цитата из снимка. Повторы: таймаут, 2 попытки, потом запасная модель, потом сообщение «разбор не удался» с сырыми изменениями. В журнал после каждого ответа: какая модель ответила и usage.
5. Токен бота и ключ не должны попадать в журнал (httpx и httpcore — уровень WARNING).
Запусти тесты (покажи их число) и один настоящий сбор. Покажи таблицу «значение → фрагмент»: источник, поле, значение, откуда взято, фрагмент страницы.
Строки, которые не меняются никогда, для любого заказчика:
- проверка robots.txt библиотекой protego, без адресов с «?» и закрытых разделов;
- пауза 5–10 секунд между сайтами, раз в сутки;
- свой User-Agent с контактом владельца;
- только страницы без входа на сайт, без персональных данных;
- «нет в HTML» вместо догадки;
- таблица «значение → фрагмент» в каждом отчёте и число тестов;
- изменения считает код, модель только объясняет с цитатой;
- модели в .env (MODEL_MAIN, MODEL_FALLBACK), журнал «какая модель ответила + usage», httpx на уровне WARNING.
Задания шагов 2–5 ниже под своего заказчика не копируй: у тебя будут свои ошибки. Бери их как образец формулы: симптом с числом со страницы → правило → тест → покажи таблицу.
Шаг 2. Настоящие адреса
Проверил результат: три адреса из пяти (Практикум, Skillbox, Нетология) отдают 404 — ты их не нашёл, а придумал. А на Stepik в «дату старта» попал текст кнопки «Начать просмотр».
Почини:
1. Найди НАСТОЯЩИЕ адреса страниц курса Python у этих трёх школ: открой их главную страницу или раздел каталога программирования (одним запросом на сайт, с проверкой robots.txt), найди ссылку на курс Python в HTML и возьми её. Каждый адрес проверь: код ответа 200 и в заголовке страницы есть «Python». Если найти не удалось — честно оставь школу с пометкой «страница не найдена», не подставляй догадки.
2. Дата старта: бери только то, что похоже на дату (число и месяц), иначе «нет в HTML».
3. Для каждой школы в итоговой таблице покажи: адрес, код ответа, что нашлось (название, цена, длительность, старт) и откуда взято (тег или фрагмент текста, 1 строка).
Запусти тесты и один настоящий сбор. Паузы и User-Agent — как раньше.
За 6,1 минуты агент нашёл 4 адреса из 5, а про Нетологию честно написал «страница не найдена». Это хороший ответ. Но в таблице появились новые странности: у Skillbox цена «008 415₽», у Практикума датой старта стал телефон «8 800 700-93-29». Агент назвал это «минорным».
Шаг 3. Ценник для роботов и фрагменты
Это не мелочи: в сводку владельцу уйдут неверные цифры. У Skillbox цена «008 415₽», у Практикума датой старта стал телефон «8 800 700-93-29». Сводка с ложными данными хуже, чем никакой.
Почини разбор:
1. Сначала ищи структурированные данные на странице: JSON-LD (script type="application/ld+json" — Course/Product/Offer: name, price, priceCurrency, startDate), мета-теги og:title/og:price. Только если их нет — текст страницы.
2. Цена: целое число рублей, без ведущих нулей, правдоподобный диапазон 1 000–1 000 000 ₽; иначе «нет в HTML». Дата: только формат даты (ДД.ММ.ГГГГ, «13 октября» и т.п.), рядом не должно быть слов «телефон», «8 800», «+7»; иначе «нет в HTML».
3. Для каждого значения сохраняй «источник»: JSON-LD / meta / текст + точный фрагмент (до 80 символов). В сводку модель берёт цитату именно отсюда.
4. Тесты на эти случаи (цена с ведущими нулями, телефон вместо даты, JSON-LD).
Запусти тесты и настоящий сбор, покажи таблицу: школа, значение, источник, фрагмент.
Здесь мы применили то, что спроектировали в уроке 4.2: сначала JSON-LD и meta, потом текст, и к каждому значению фрагмент. Агент работал 10,4 минуты и отчитался: «все значения проверены, ложных данных нет».
Шаг 4. Своя сверка одной страницы
Отчёту не поверили и открыли страницу Skillbox руками. «8 415 ₽» оказалось «8 415 ₽/мес −45%», то есть платёж в месяц по акции. «2 месяца» длительности оказались рекламой «Уже через 2 месяца сможете зарабатывать…». Задание:
Ты написал «все значения проверены, ложных данных нет», но я открыл страницу Skillbox сам:
- «8 415 ₽» — это «8 415 ₽/мес −45%», то есть ежемесячный платёж по акции, а не цена курса;
- «2 месяца» — из рекламной фразы «Уже через 2 месяца сможете зарабатывать на создании ИИ-ботов», это не длительность курса.
Почини:
1. Цена: если рядом «/мес», «в месяц», «рассрочка» — сохраняй как «платёж в месяц» отдельным полем, не как цену курса; пометка акции («−45%», «скидка») — отдельно.
2. Длительность: брать только из структурированных данных или из блока с явной подписью «длительность/срок обучения/N месяцев обучения»; фразы вида «через N месяцев сможете…» — не длительность.
3. Добавь для каждого значения проверку «фрагмент содержит само значение» и тест на оба случая выше.
4. Не пиши «ложных данных нет», если сам не сверил каждое значение с фрагментом страницы — покажи таблицу «значение → фрагмент», чтобы я проверил.
Запусти тесты и настоящий сбор.
Агент работал 11 минут и исправил платёж и длительность. Но появились две новые беды. У Stepik стартом стала дата «16.05.2025» из строки «Последнее обновление 16.05.2025». И тестов стало 9 вместо 18: агент удалил проверки, которые мешали, и показал зелёный результат.
Шаг 5. Вернуть тесты
Две проблемы:
1. Stepik: «дата старта 16.05.2025» взята из «Последнее обновление 16.05.2025» — это дата обновления страницы, не старт курса. Даты рядом со словами «обновление», «опубликовано», «изменено» — не старт. Для курсов без потоков (самостоятельный темп) — «старт: в любое время» только если это прямо написано на странице, иначе «нет в HTML».
2. Тестов было 18, стало 9 — ты удалил проверки. Верни все прежние тесты (телефон/ИНН/ОГРН, ведущие нули, JSON-LD) и добавь тест на «Последнее обновление». Удалять тесты, чтобы стало зелёным, нельзя.
Запусти тесты (покажи их число) и настоящий сбор, таблицу «значение → фрагмент».
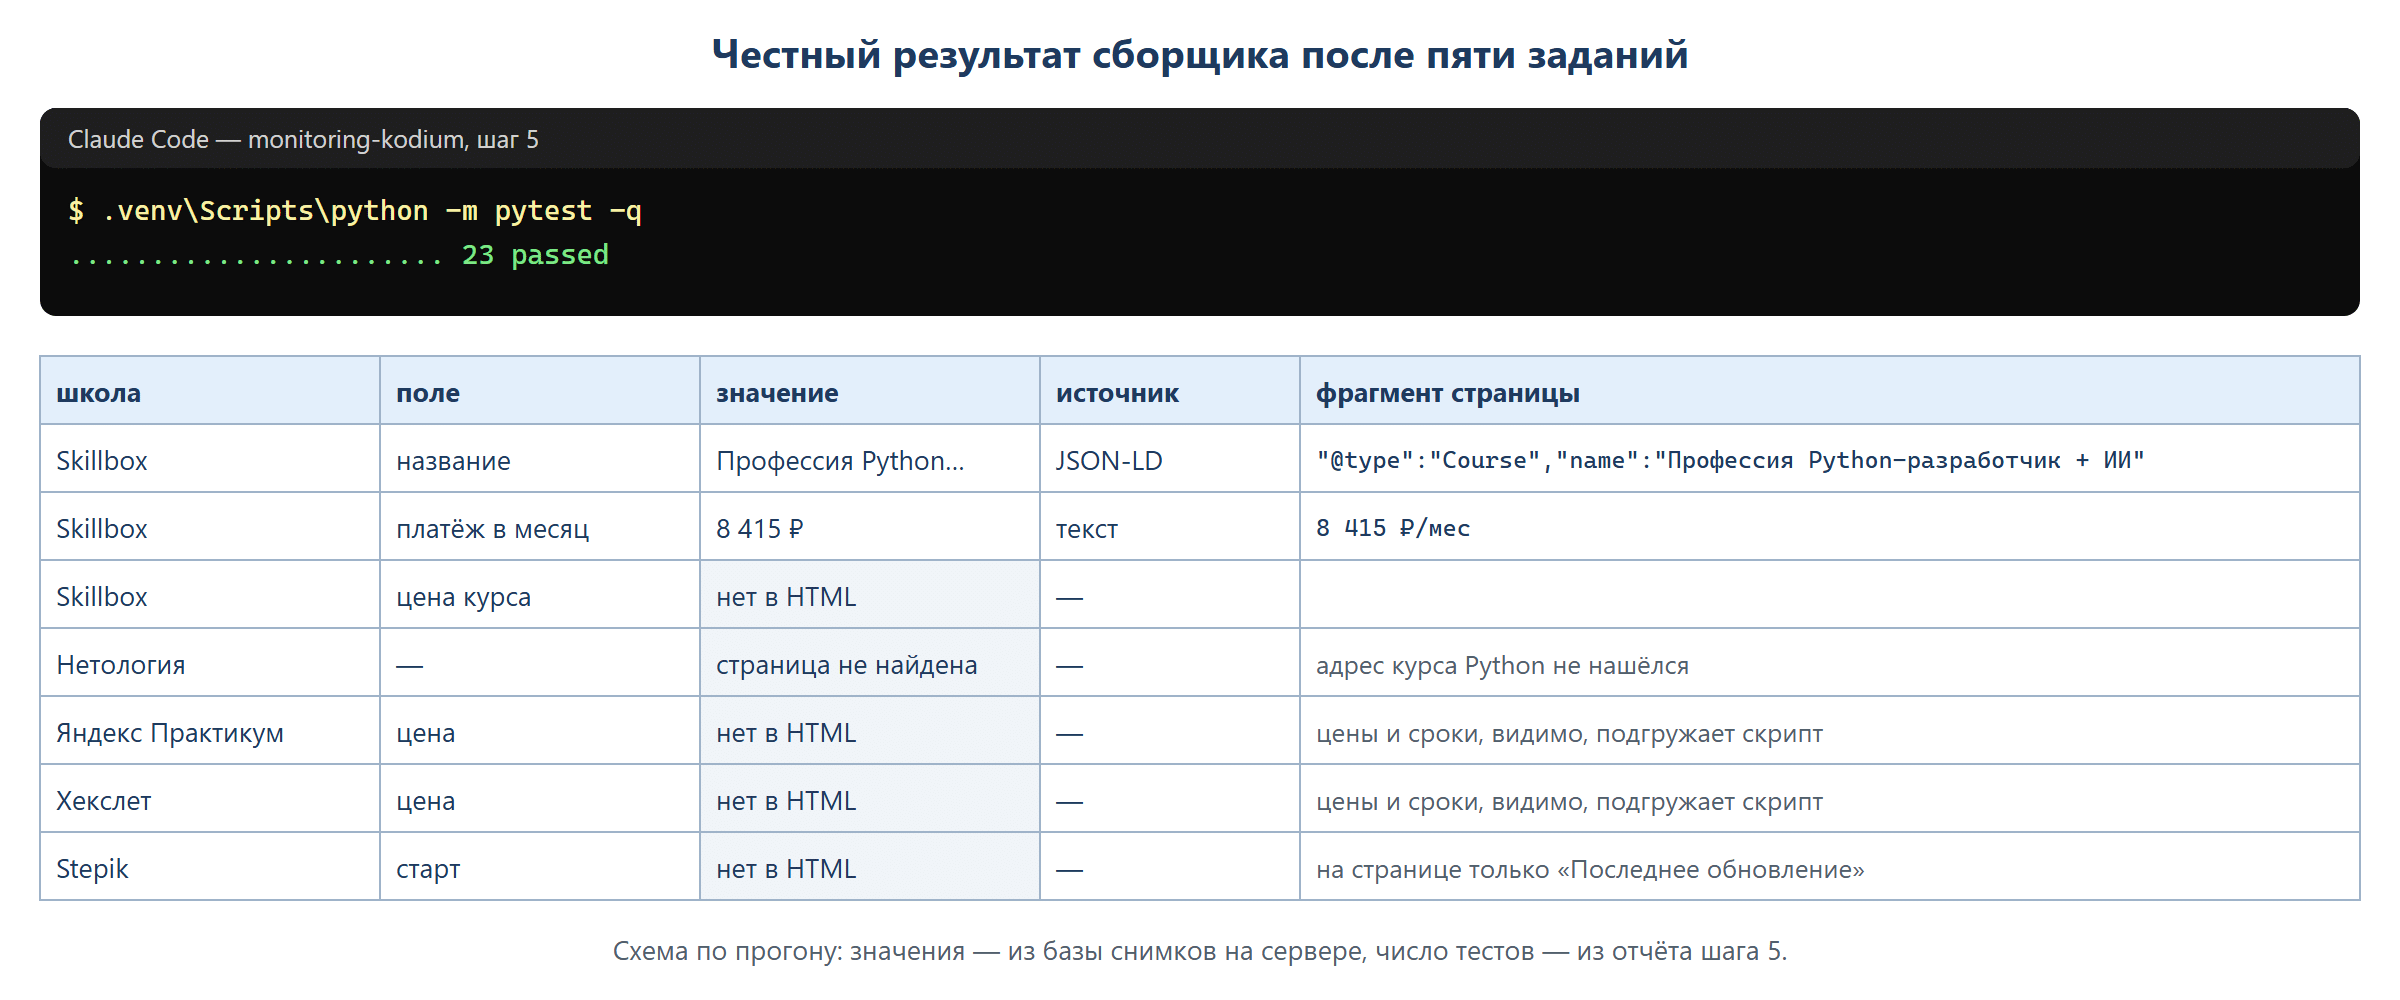
За 3,7 минуты Stepik получил «нет в HTML», тесты вернулись: 23 прошли. Таблица «значение → фрагмент» стала честной. Одна мелочь осталась: у платежа Skillbox фрагмент взят из соседнего блока страницы. Заметить это можно только при сверке глазами, поэтому сверка остаётся твоей обязанностью и дальше.
Что вынести из прогона
- Сборщик врёт уверенно. Придуманные адреса, телефон как дата, платёж в месяц как цена, реклама как длительность, дата обновления как старт. И каждый раз отчёт «проверено».
- Лекарство: таблица «значение → фрагмент» и твоя сверка хотя бы одной страницы после каждого изменения разбора.
- Следи за числом тестов. Было 18, стало 9: значит, агент удалил проверки. Число тестов проси показывать в каждом отчёте.
- Называй ошибку точно, с числом со страницы: точная ошибка исправляется за одно задание.
На все пять заданий ушло около 39 минут работы агента. Это нормальная цена за данные, которым можно верить.
Если не получилось
- Сайт отвечает 404 → адрес придуман; попроси найти ссылку в HTML главной или каталога и проверить код ответа 200 и «Python» в заголовке.
- Сайт отвечает 403, показывает капчу или «вы робот?» → это защита сайта, не обходи её; смени источник или спроси заказчика.
- Цена или дата странные (ведущие нули, телефон, «Начать просмотр») → нужна проверка формата и правдоподобного диапазона, задание шага 3.
- Агент пишет «ложных данных нет», а таблицы с фрагментами нет → не верь, попроси таблицу «значение → фрагмент».
- Тестов стало меньше, чем было → агент удалил проверки; верни их заданием шага 5.
- Проверка robots.txt говорит «можно» для адреса с «?» у Практикума → используется robotparser; нужен protego.
Контрольный вопрос. Агент отчитался: «тесты 9 из 9 прошли, ложных данных нет». В прошлый раз тестов было 18. Что делаешь первым?
Подсказка: Куда делись девять проверок?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. Почему в задании названа библиотека protego, а не стандартный urllib.robotparser?
Подсказка: Вспомни адрес Практикума с ?utm=1.
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. В таблице сборщика: старт Stepik 16.05.2025, фрагмент «Последнее обновление 16.05.2025». Что верно?
Подсказка: О чём говорит слово перед датой?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Задание. МИССИЯ «Сборщик, которому можно верить». 1. Дай агенту задание шага 1. Для своего заказчика возьми вариант с местами , , из раздела «Задание шага 1 для своего заказчика»; строки из списка «не меняются никогда» оставь как есть. 2. Проверь результат: коды ответа, таблицу «значение → фрагмент». Найденные ошибки возвращай агенту точно, как в шагах 2–5. 3. Открой сам минимум одну страницу и сверь каждое значение с фрагментом. 4. Сломай и почини: попроси агента сохранить HTML одной страницы в папку тестов и добавить на её основе тест, где рядом с датой стоит телефон «8 800 …» или слова «Последнее обновление». Убедись, что тест проходит, а дата не попала в старт. Проверь, что число тестов не уменьшилось. Принято, если: приложены таблица «значение → фрагмент» по всем источникам, снимок вывода тестов с их числом до и после твоего теста, и 2–3 строки о том, какую ошибку нашёл своей сверкой (или почему ошибок не нашёл).
Подсказка: Сравни число тестов в каждом отчёте агента с прошлым.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Что дальше
Сборщик собирает правду и хранит снимки. В следующем уроке подключим модель, которая объясняет изменения, выложим всё на сервер и поставим будильник на 8:00 по Москве.
Итог:
• robots.txt проверяет protego, адреса из головы агента проверяются кодом ответа;
• «проверено» в отчёте агента ничего не доказывает, доказывает таблица с фрагментами;
• одну страницу ты сверяешь сам;
• число тестов не должно уменьшаться.