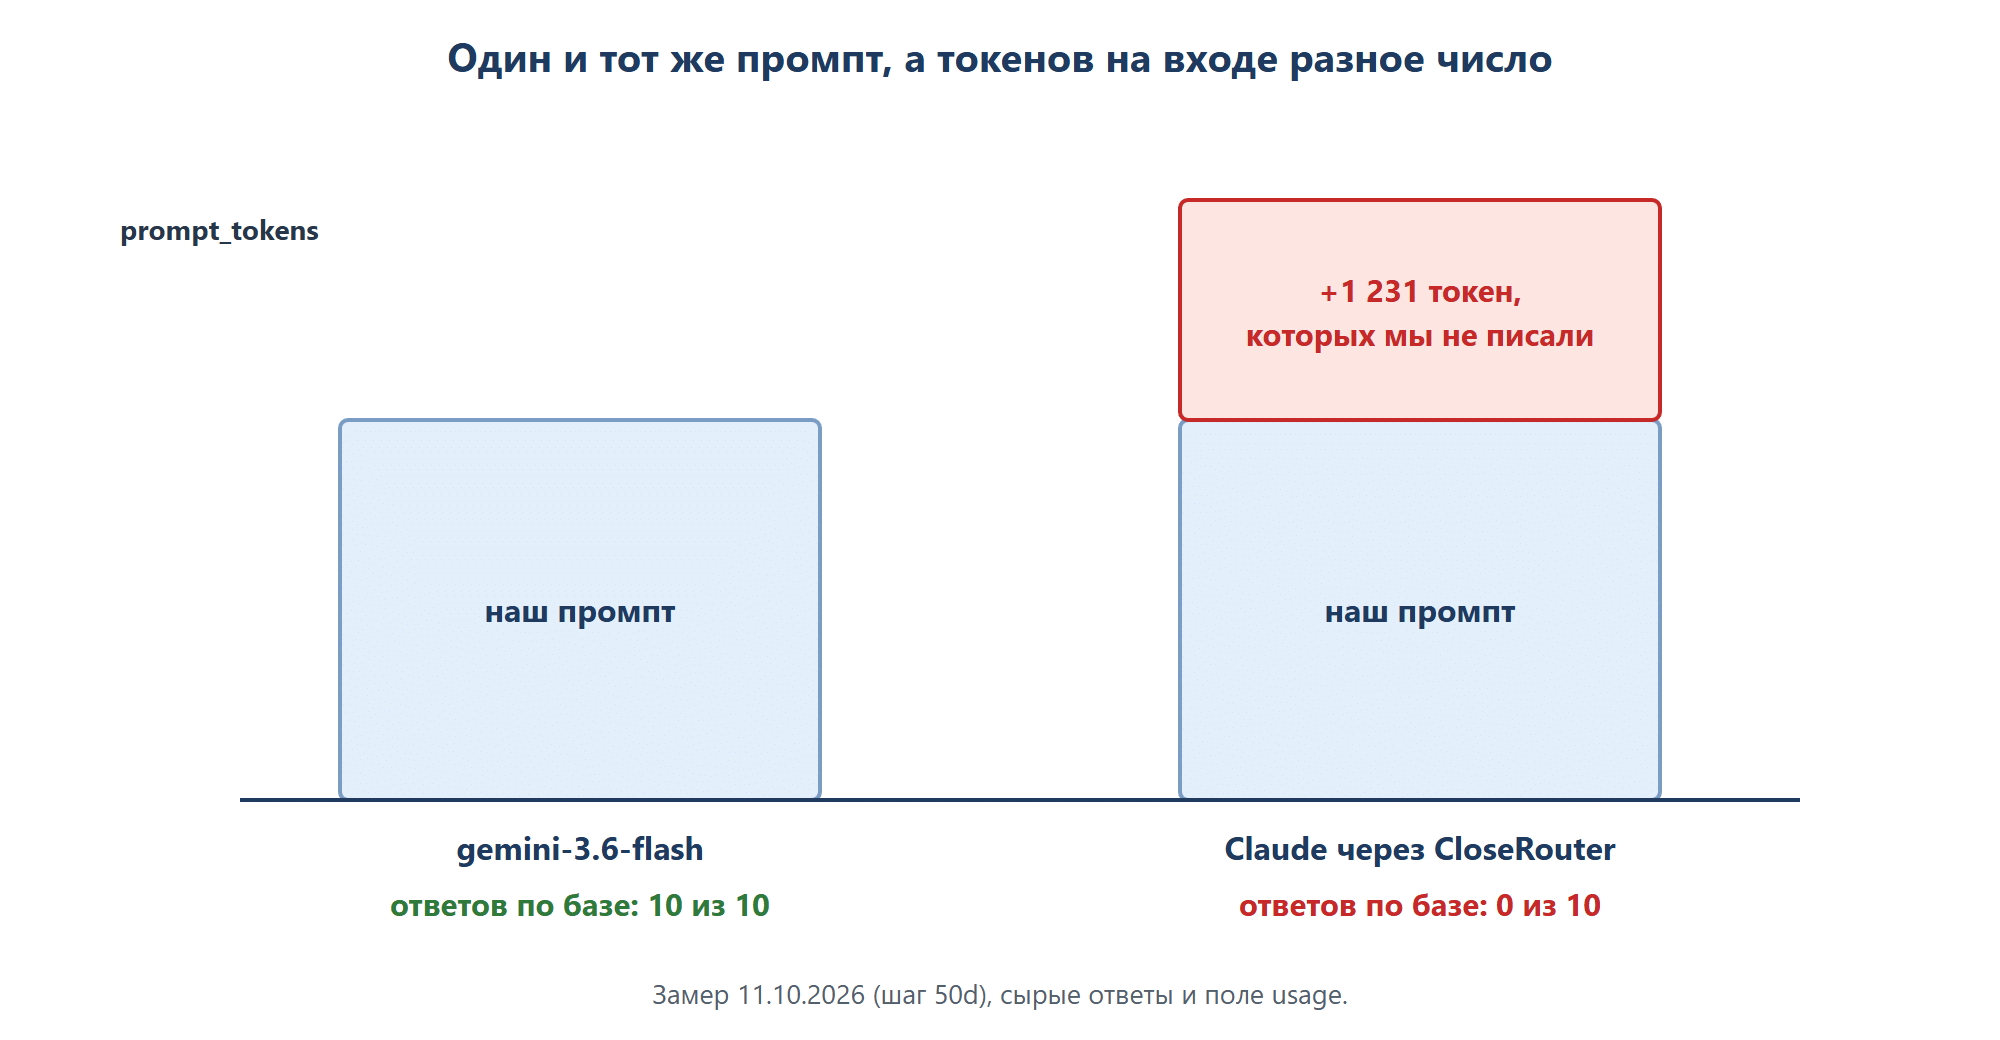
«Беру anthropic/claude-sonnet-4, он лучше следует инструкциям». Так агент в прогоне выбрал модель для ассистента, ещё до первой строчки кода. Название он взял по памяти, и оно устарело, а в файле настроек уже стояли другие модели. Когда мы вместо мнения сделали замер, модели Claude через CloseRouter ответили по базе «Кодиума» 0 раз из 10.
Чему научишься в этом уроке:
• заводить git в папке проекта перед новой работой;
• давать агенту задание на замер моделей без кода бота;
• читать сырые ответы и поля расхода, а не итоговую фразу агента;
• применять четыре правила проверки модели перед тем, как поставить её в работу;
• мерить скорость ответа с того сервера, где живёт бот.
Перед стартом
- Бот «Кодиума» из П1 лежит у тебя в папке проекта, и он же работает на сервере в Амстердаме.
- В
.envбота ты сам положил ключ CloseRouter и две модели:CLOSEROUTER_API_KEY,MODEL_MAIN,MODEL_FALLBACK. В прогоне это были google/gemini-3.6-flash и openai/gpt-5.4-mini. Ключ лежит в.env, в чат ты его не вставляешь (как в уроке 1.8). Показывать ключ агенту не нужно, но прочитать.envон может, поэтому в каждом задании стоит «ключ не печатать». - В кабинете CloseRouter у ключа стоит лимит расхода. В П6 учебный лимит 5 $ кончился посреди шага, на П7 закладывай запас.
- Комплект проверок из урока 1.11 установлен.
Задание 49. git и план
В П4–П6 у папки бота не было git, и откатить неудачную правку было нечем. Первым делом заводим его. Вместо <путь к папке проекта> подставь свой путь.
Работай ТОЛЬКО в текущей папке проекта (<путь к папке проекта>). Другие папки не открывай и не меняй. На сервер не выкладывай. Отвечай по-русски. У тебя установлен комплект навыков и проверок (~/.claude) — пользуйся им.
Это Telegram-бот «Кодиума» из П1 (aiogram): сценарий заявки с согласием → заявка уходит в CRM. Новая задача — «Ассистент приёмной»: человек пишет боту вопрос свободным текстом, бот отвечает по базе знаний школы через модель CloseRouter (ключ и модели — CLOSEROUTER_API_KEY, MODEL_MAIN, MODEL_FALLBACK в .env, я их уже положил).
Правила: отвечает только по базе знаний; чего нет в базе — честно «не знаю» и предлагает человека; хочет записаться — запускается ГОТОВЫЙ сценарий заявки (модель сама заявку не пишет и имени/телефона не видит: телефоны и почты в тексте заменяются пометкой до отправки модели); жалобы, возвраты, вопросы без ответа — передача администратору (OWNER_CHAT_ID) без персональных данных; история диалога только в памяти, 30–60 минут; лимиты на длину и частоту.
1. Сначала заведи git в этой папке (git init, .gitignore: .env, *.db, логи, .venv) и сделай первый коммит текущего состояния.
2. Потом — только план, без правок кода: файлы, формат ответа модели (JSON: answer / action: none|lead|handoff), где маска персональных данных, что пишется в журнал (без текстов сообщений и телефонов), какие тесты, какая модель и почему. Без PostgreSQL, векторной базы и новых сервисов.
3. Базу знаний (knowledge/kodium.md) предложи черновиком в ответе: курсы, длительность, цены, рассрочка, возврат, расписание, и отдельным разделом «чего школа не делает». Бери данные «Кодиума» из этой папки (курсы в сценарии заявки), остальное придумай правдоподобно — отметь, что придумано.
План вышел годный: курсы агент взял из сценария бота, без PostgreSQL и векторной базы. Две вещи я поправил. Модели по умолчанию были из памяти: anthropic/claude-sonnet-4 и gpt-4o-mini. А маска «слово с заглавной буквы = имя» закрыла бы пометкой «Python», «Нейросети» и первое слово каждой фразы.
Задание 50. Замер вместо мнения
План годный, курсы взяты из бота — хорошо. Две правки к плану, прежде чем писать код:
- Модель: ты предлагаешь по умолчанию anthropic/claude-sonnet-4 и gpt-4o-mini. В .env уже стоят MODEL_MAIN=google/gemini-3.6-flash и MODEL_FALLBACK=openai/gpt-5.4-mini; названия по умолчанию из памяти устарели. Выбор модели решим замером, не мнением.
- Маска «слово с заглавной = имя» испортит вопросы («Python», «Нейросети», начало фразы). Имена не маскируем эвристикой: модель их не просит, а запись идёт готовым сценарием. Маскируем телефоны и почты.
Сейчас — шаг замера, БЕЗ кода бота. Отдельный скрипт scripts/zamer_modeley.py: один и тот же системный промпт (черновик базы знаний + правила + формат JSON) и 5 разных вопросов к трём моделям: google/gemini-3.6-flash, openai/gpt-5.4-mini, anthropic/claude-sonnet-5. Для каждого вызова записать в таблицу: модель, prompt_tokens (и сравнить с длиной нашего промпта — нет ли скрытой добавки), completion_tokens, рассуждения (если есть в usage), cached/cache_read на повторном вызове, стоимость из usage (если есть), время ответа, валиден ли JSON, не вышла ли модель из роли. Ключ — из .env, в вывод не печатать. Сохрани базу знаний в knowledge/kodium.md. Закоммить. В ответе — таблица и вывод: какую модель ставим и почему, с цифрами. Отвечай по-русски.
Задание 50b разрешает агенту запустить скрипт:
Запуск скрипта теперь разрешён (.venv\Scripts\python.exe). Запусти замер сам, разберись с ошибками, если будут, и дай таблицу и вывод с цифрами. Отвечай по-русски.Тут случилось два неприятных эпизода. Сначала скрипт не запустился из-за разрешения на команду. Потом пришла ошибка 401 (сервер не принял ключ), и агент сделал вывод, что CloseRouter — «вымышленный сервис», и предложил взять «публичные бенчмарки». Настоящая причина была в его же скрипте: адрес api.closerouter.ai он придумал, правильный домен closerouter.dev. А в ответе агент напечатал начало ключа. Так нельзя: в задании ниже вместо настоящих символов стоит closerouter_<начало ключа>….
Задание 50c. Адрес из документации, ключ не печатать
CloseRouter — настоящий сервис, ключ рабочий. Ошибка в адресе: в скрипте стоит api.closerouter.ai — домен ты придумал. Правильный адрес и формат — в документации: https://closerouter.dev/closerouter-api.md (прочитай её, не угадывай). Через этот же ключ сейчас работают мониторинг и дашборд из прошлых модулей.
И ещё: в ответе ты напечатал начало ключа (closerouter_<начало ключа>…). Ключ нельзя показывать ни целиком, ни частично — даже в рассуждениях.
Почини адрес по документации, запусти замер, дай таблицу и вывод с цифрами. Отвечай по-русски.
Ключ нельзя показывать ни целиком, ни кусочком. Даже первые символы сужают перебор и попадают в историю чата. Увидел кусок ключа в ответе агента — скажи ему об этом прямо, а сам ключ в кабинете CloseRouter замени на новый.
Задание 50d. Сырые ответы
Замер прошёл, агент принёс таблицу и вывод. Я открыл файл с результатами: ответов моделей там не было, только «JSON верный: да/нет». Кэш и стоимость везде нули, а «добавка» у gpt посчитана средним, в которое попал один вызов на 6 141 токен.
Я открыл scripts/benchmark_results.json — вывод делать рано:
1. Ответов моделей в файле нет — только «JSON верный: да/нет». Почему gemini «провалился» 2 раза, а Claude 5 раз, не видно; «видимо» — не вывод. Сохраняй сырой ответ каждой модели. Частая причина — JSON в обёртке ```json ... ``` — это не нарушение роли: разбор должен её снимать, а «вышла из роли» считать отдельно, по смыслу ответа.
2. cached_tokens, cache_read_tokens и total_cost — нули во всех 15 вызовах. Кэш у CloseRouter работает (в прошлом модуле был виден) — значит, скрипт читает не те поля. Посмотри в документации https://closerouter.dev/closerouter-api.md и в сыром usage одного ответа, где лежат кэш и стоимость.
3. У gpt-5.4-mini первый вызов 6 141 токенов промпта, остальные ~1 770 — среднее 2 644 вводит в заблуждение. Показывай по вызовам, а «добавку» считай не от длины в символах (/4 для русского текста неверно), а сравнением моделей между собой на одном промпте.
Сделай каждый вопрос дважды подряд (второй раз — для кэша). Перезапусти, покажи таблицу по вызовам и по три сырых ответа gemini и Claude, которые не прошли. Потом вывод. Отвечай по-русски, ключ не печатать.
Что показал честный замер
- gpt-5.4-mini и gemini-3.6-flash ответили по базе 10 из 10.
- Claude через CloseRouter: 0 из 10. Он отвечал как универсальный помощник: «существуют тысячи курсов Python…», «какую школу вы рассматриваете?». Базу и формат бланка не замечал.
- На одном и том же промпте у Claude
prompt_tokensна 1 231 больше, чем у gemini. Это скрытая инструкция прокси: CloseRouter отдаёт модели Anthropic через Claude Code и подмешивает свою инструкцию, наша идёт вторым голосом. - Один ответ стоил около 0,000116 $ у gpt-5.4-mini и около 0,000244 $ у gemini-3.6-flash.
Ещё три поправки я нашёл сам, открыв сырой ответ одного вызова. Стоимость лежит в usage.cost, а агент писал null. У gemini есть скрытые рассуждения (модель сначала «думает» про себя, и это оплачивается как ответ): в поле usage.completion_tokens_details.reasoning_tokens около 300 из примерно 400 токенов ответа, у агента было 0. Поэтому gemini дороже gpt, хотя цена за токен у неё ниже. А кэша на дату прогона действительно не было.
Вот так выглядит сырой ответ gemini на «Сколько стоит курс Python?» (сокращён):
{
  "answer": "Стоимость курса «Python для начинающих» зависит от формата обучения: ... В группе (до 6 человек) — 1 500 руб. за занятие (72 000 руб. за полный курс из 48 занятий) ...",
  "action": "none",
  "context": "Предоставлена информация о стоимости курса Python для начинающих"
}
Четыре правила проверки модели
Ошибка за всеми четырьмя одна: одно наблюдение принимают за свойство модели. Правила пришли из боевых случаев ИИ-наставника и подходят любому ассистенту.
- Формат проверяют минимум на двух непохожих вопросах. Модель, давшая верный бланк 3 раза из 3 на одном вопросе, на другом вернула другую схему целиком, с русскими названиями полей. Для ассистента: короткий вопрос и длинный, с ответом в базе и без.
- Скорость меряют несколькими проходами в разные часы. Время ответа поставщика менялось втрое за пять минут. Один замер годится, чтобы заметить, и не годится, чтобы решать.
- Роль проверяют отдельно: настоящий промпт целиком, короткий диалог и прямая просьба нарушить. Один срыв означает отказ от модели, допуск даёт минимум два чистых прогона. Через прокси вердикт живёт, пока не поменялся маршрут, поэтому перепроверять периодически.
- Поддакивание проверяют вопросом с уверенным неверным числом. «Курс ведь 3 месяца?» при 6 в базе. Согласие с однозначно неверной ценой или сроком означает отказ от модели.
Почему правило про маршрут не формальность: во внутреннем замере 06.10 Claude Sonnet 5 через CloseRouter роль держал, а 11.10 ответил по базе 0 раз из 10. Полный прогон по этим правилам — в уроке 8.5. Сейчас из замера берём главное: модели Anthropic для роли ассистента через CloseRouter не ставим без своего теста.
Скорость меряй с сервера бота
По замеру с моего ноутбука основной стала gpt-5.4-mini, запасной gemini. В живом боте вышло иначе. С сервера в Амстердаме gpt-5.4-mini не отвечала за 60 секунд (с ноутбука 9,4 секунды). Бот ждал её, потом переключался на gemini, и человек получал ответ через 35–42 секунды. На «Кто ты?» обе модели не успели, и бот написал «Извините, произошла ошибка». Gemini с сервера отвечала за 3–7 секунд, её и поставили основной.
Вывод: скорость меряют там, где работает бот, и в разные часы. Для этого хватит короткой пробы: один и тот же вопрос к основной и запасной модели и время ответа. Файл кладут на сервер временно, в /tmp, запускают два раза с перерывом в час и удаляют. В папку бота его не клади: scripts/ на сервер не выкладываем (урок 8.6), а после замера проба не нужна. Адрес запроса сверь с тем, что стоит в коде бота (документация closerouter.dev/closerouter-api.md). Ключ проба берёт из .env бота и не печатает.
# proba.py: временная проба скорости с сервера бота. После замера удалить.
import json, time, urllib.request

env = {}
for line in open("/opt/bot-kodium/.env", encoding="utf-8"):
    if "=" in line and not line.startswith("#"):
        k, v = line.strip().split("=", 1)
        env[k] = v.strip('"')

for model in (env["MODEL_MAIN"], env["MODEL_FALLBACK"]):
    body = json.dumps({"model": model, "messages": [
        {"role": "user", "content": "Сколько длится курс Python?"}]}).encode()
    req = urllib.request.Request(
        "https://api.closerouter.dev/v1/chat/completions", data=body,
        headers={"Authorization": "Bearer " + env["CLOSEROUTER_API_KEY"],
                 "Content-Type": "application/json"})
    t = time.time()
    try:
        urllib.request.urlopen(req, timeout=90).read()
        print(model, round(time.time() - t, 1), "с", time.strftime("%H:%M"))
    except Exception as e:
        print(model, "ошибка", type(e).__name__, round(time.time() - t, 1), "с")
scp -i ~/.ssh/<файл SSH-ключа> proba.py root@<адрес сервера>:/tmp/proba.py
ssh -i ~/.ssh/<файл SSH-ключа> root@<адрес сервера> "python3 /tmp/proba.py"
# через час ещё раз вторую строку, потом удалить:
ssh -i ~/.ssh/<файл SSH-ключа> root@<адрес сервера> "rm /tmp/proba.py"Цены моделей меняются. Пример на 11.10.2026 за миллион токенов, вход и выход: gemini-3.6-flash 0,03 и 0,15 $; gpt-5.4-mini 0,0587 и 0,352 $. Та же gpt-5.4-mini 9 октября стоила 0,0225 и 0,135 $. Свежие цены смотри на главной CloseRouter или запросом списка моделей со своим ключом.
Сломай и почини
- Запусти замер дважды с перерывом в час и сравни время ответа одних и тех же моделей. Разница в разы — нормальная картина, решение принимай по обоим проходам.
- Временно убери из базы раздел «Чего школа не делает», задай в скрипте замера вопрос «Готовите к ЕГЭ по информатике?» и прочитай сырые ответы. Если модель достроила «да», ты увидел, зачем этот раздел. Верни раздел и прогони снова.
Если не получилось
- Агент выбирает модель «потому что лучше следует инструкциям» → попроси замер на твоих моделях из
.env, выбор только по таблице. - Ошибка 401, агент говорит, что сервис не существует → проверь адрес в скрипте по документации
closerouter.dev/closerouter-api.md; ключ рабочий, если через него отвечают мониторинг и дашборд. - В ответе агента кусок ключа → скажи агенту, замени ключ в кабинете CloseRouter.
- В таблице «JSON неверный» без причины → попроси сырой ответ; часто там обёртка из кавычек, её снимает код.
- Стоимость и рассуждения нули → открой сырой
usageодного ответа и покажи агенту, где лежатcostиreasoning_tokens. - У модели
prompt_tokensнамного больше, чем у других на том же промпте → скрытая инструкция прокси; эту модель для роли не ставь без теста роли. - С ноутбука модель быстрая, в боте долгие ответы → замерь с сервера бота.
- Нужно вернуть код как было →
git revert <хеш неудачного коммита>: он отменяет коммит новым коммитом, история остаётся. Вернуть один файл как в последнем коммите:git checkout -- <файл>.git reset --hardкомплект из урока 1.11 блокирует намеренно: он стирает несохранённое.
Контрольный вопрос. Замер: модель A ответила по базе 10 из 10, у модели B prompt_tokens на том же промпте на 1 231 больше, а отвечает она про «тысячи курсов Python». Что это значит?
Подсказка: Откуда в запросе берутся токены, которых ты не писал?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. Агент получил ошибку 401 и пишет: «CloseRouter, видимо, вымышленный сервис, предлагаю публичные бенчмарки». Мониторинг и дашборд через тот же ключ работают. Что проверить первым?
Подсказка: Если ключ работает в других программах, где ошибка?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Контрольный вопрос. С ноутбука модель отвечает за 9 секунд, а бот на сервере ждёт её 60 секунд и не дожидается. Как правильно выбрать основную модель?
Подсказка: Где живёт бот и где он ждёт ответа?
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Задание. МИССИЯ «Модель по замеру». 1. В папке своего бота заведи git и сделай первый коммит (задание 49, свой путь). 2. Дай агенту задания 50 и 50d по образцу урока: один системный промпт со своей базой, пять разных вопросов, каждый дважды, три модели, сырые ответы в файл. 3. Открой файл результатов сам. Посчитай по сырым ответам, сколько раз каждая модель ответила по базе. Найди у одного ответа usage.cost и reasoning_tokens. 4. Сравни prompt_tokens разных моделей на одном промпте. 5. Запусти пробу скорости с сервера бота (proba.py из урока) два раза с перерывом не меньше часа, запиши время ответа и удали пробу с сервера. 6. Выбери основную и запасную модель. Принято, если: приложены строка git log с первым коммитом, таблица «модель → ответов по базе из 10 → prompt_tokens → cost одного ответа → reasoning_tokens», по одному сырому ответу на каждую модель, время ответа с сервера в двух проходах с указанием часа и твой выбор основной и запасной модели с объяснением в двух-трёх предложениях. Ключа (даже части) в приложенном нет.
Подсказка: Сначала посчитай ответы по базе в сырых ответах, а потом сравни со своим счётом то, что написал агент.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
На курсе задания проверяются автоматически. Решить первое задание бесплатно → · Подобрать курс
Что дальше
Модель выбрана замером. Дальше собираем самого ассистента в боте: маска телефонов, история, лимиты, запасная модель, запись и передача администратору.
Итог:
• в папке бота есть git, и каждый шаг можно откатить;
• модель выбирается по таблице замера, а не по памяти агента;
• выводы делаются по сырым ответам и полям usage, а не по итоговой фразе;
• модели Anthropic через CloseRouter для роли без своего теста не ставятся;
• скорость меряется с сервера бота, в разные часы.