В первой сборке разбора отзывов кофейни «Зерно» темы считал код, а модель размечала отзывы и писала по таблице разбор для управляющего. Текст читался гладко, но гостей в нём было не узнать. Жалобы на вай-фай и на цены не получили ни одной негативной пометки, хотя гости на них жаловались. Выпечку разбор ругал за «свежесть», а гости писали другое: к вечеру выпечка заканчивается. В этом уроке вы соберёте разбор, где считает программа, разметку держит строгое правило, а выдумки вы ловите сами.
Чему научитесь в этом уроке:
• принимать файл с отзывами через форму n8n и читать из него строки;
• просить модель разметить каждый отзыв: тональность и одна тема из закрытого списка, с правилом, что жалоба всегда «негатив»;
• считать темы и тональности в узле Code, без участия модели;
• получать от второй модели короткий разбор для управляющего: что хвалят, три главные проблемы и что с ними делать.
Книга отзывов и карандаш
Представьте книгу жалоб и предложений, которую управляющий разбирает в конце месяца. Он идёт по записям и ставит на полях пометку раздела: «касса», «выпечка», «кофе». Потом считает пометки в каждом разделе и только после этого решает, с чего начать. Пометки требуют понимания: «очередь минут на 10» и «долго ждала латте» относятся к одному разделу, хотя слова разные. Подсчёт понимания не требует, его сделает и калькулятор.
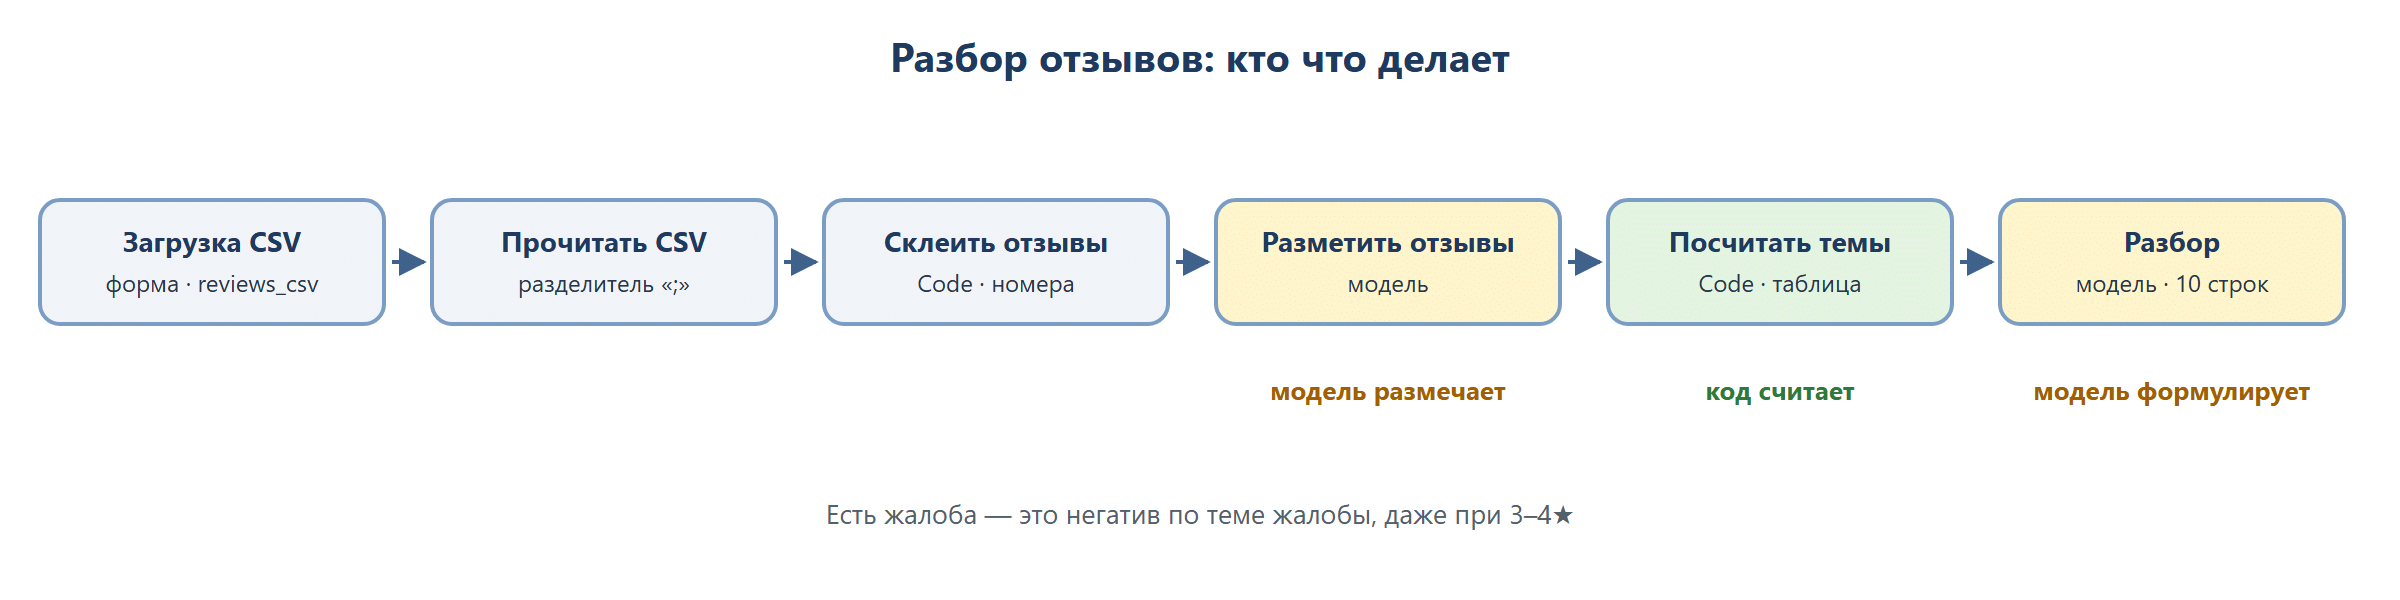
В сценарии роли делятся так же. Модель читает отзывы и ставит пометки, с этим она справляется. Подсчёт делает узел Code (узел, в котором пишется короткая программа на JavaScript), он не устаёт и не округляет в удобную сторону. Вторая модель получает готовую таблицу и пишет по ней человеческий текст.
Узел 1. Форма «Загрузка CSV»
Отзывы приходят файлом, поэтому сценарий начинается с узла Form Trigger: n8n показывает простую веб-страницу с полем для файла, и сценарий запускается, когда файл отправлен. Такую форму вы уже собирали в уроке 3.5, там она принимала фото товара. Назовите узел «Загрузка CSV» и добавьте одно поле с типом «файл», допустимое расширение .csv.
Подпись поля напишите латиницей: reviews_csv. В прогоне курса с русской подписью n8n превратил кириллицу в знаки «_», и следующему узлу стало трудно найти файл по имени. Латинская подпись снимает эту проблему.
Для пробы возьмите учебный файл otzyvy.csv из материалов модуля. В нём 50 отзывов о «Зерне» с Яндекс Карт, 2ГИС и ВКонтакте, а в первой строке заголовок: Дата;Площадка;Оценка;Текст. Столбцы разделены точкой с запятой. Файл учебный: многие тексты в нём повторяются два-три раза с разными датами. Выгрузку отзывов с настоящих площадок в прогоне курса не делали, так что свой файл сначала приведите к тем же четырём столбцам.
Тестовая форма работает, только пока сценарий её ждёт. Сначала нажмите в редакторе Execute workflow, потом отправляйте файл. Если после Submit сценарий молчит, проверьте, что редактор всё ещё пишет «Waiting for you to submit the form», и отправьте форму ещё раз. При подготовке курса форма иногда не отправлялась с первого нажатия.
Узел 2. «Прочитать CSV»
Узел Extract From File достаёт из файла строки таблицы. Назовите его «Прочитать CSV», формат CSV, разделитель «;». Если оставить запятую, вся строка отзыва попадёт в один столбец и дальше ничего не сойдётся. Поле с именем файла должно совпадать с подписью поля формы, reviews_csv. На выходе узла 50 строк, у каждой поля Дата, Площадка, Оценка и Текст.
Узел 3. Code «Склеить отзывы»
Модели удобнее получить один список, чем 50 отдельных строк. Этот код нумерует отзывы, рядом с каждым ставит оценку со звёздочкой и запоминает, сколько всего отзывов пришло:
// Склеить отзывы: нумеруем отзывы для модели
const rows = $input.all().map(i => i.json);
const list = rows.map((r, i) => (i + 1) + '. [' + r['Оценка'] + '★] ' + r['Текст']).join('\n');
return [{ json: { list, total: rows.length } }];
Номер нужен, чтобы потом сверить: каждый ли отзыв получил пометку. Поле total пригодится в подсчёте.
Узел 4. «Разметить отзывы»
Узел Basic LLM Chain (отправляет модели системное сообщение и вашу просьбу, возвращает ответ) с именем «Разметить отзывы». Модель в прогоне курса была google/gemini-3.6-flash через CloseRouter, подключение разобрано в уроке трека 2 «Подключаем модель». Системное сообщение:
Ты аналитик отзывов кофейни. На вход — список отзывов, каждый с номером.
Для КАЖДОГО отзыва определи тональность (позитив / нейтрально / негатив) и одну тему из списка: вкус кофе, выпечка, скорость обслуживания, персонал, цены, интерьер и шум, розетки и вай-фай, другое.
Правило тональности: если в отзыве есть жалоба, тональность «негатив», а тема — тема жалобы, даже при оценке 3–4★ и даже если рядом есть похвала. «Позитив» — только отзыв без жалоб. «Нейтрально» — отзыв без оценки качества.
Верни только JSON-массив без пояснений: [{"n": номер, "sentiment": "...", "theme": "..."}]. Ровно столько элементов, сколько отзывов.
Сообщение пользователя: {{ $json.list }}, то есть пронумерованный список из прошлого узла.
Главное в этом промпте закрытый список тем. Без него модель назовёт одну и ту же беду то «очередью», то «медленным обслуживанием», и подсчёт разъедется по трём строкам. Тема «другое» оставляет выход для отзывов, которые ни к чему не подходят. Тональность тоже выбирается из трёх слов, и код потом сравнивает их буквально.
Вторая важная строка, правило тональности, появилась после проверки урока. Многие жалобы стоят рядом с похвалой и средней оценкой, например «Кофе вкусный, вай-фай постоянно отваливается» на 4★. Без правила такие отзывы не попадали в негатив, и в первом прогоне вай-фай и цены остались вовсе без жалоб.
Если в отзыве две жалобы сразу, модель выберет одну тему сама. Можно дописать в промпт: «если жалоб несколько, тема та, на которую гость жалуется в первую очередь». В прогоне курса это правило не проверяли.
Ещё одна настройка в самом узле модели, который подключён к «Разметить отзывы». Откройте в нём Options и задайте Timeout 180000 (время ожидания ответа в тысячных долях секунды, то есть три минуты) и Max Retries 2 (сколько раз повторить запрос, если он сорвался). Без этого в прогоне 50 отзывов падали с ошибкой «Request timed out»: модель не успевала ответить.
Узел 5. Code «Посчитать темы»
Этот узел вырезает из ответа модели JSON-массив (список в строгом формате «поле: значение»), проходит по нему и считает для каждой темы: сколько всего отзывов, сколько негативных, сколько позитивных. Темы сортируются по числу негатива, сверху самые больные места.
// Посчитать темы: считаем темы и тональности кодом — модель только размечает
const raw = $input.first().json.text || '';
const arr = JSON.parse(raw.replace(/^[^\[]*/, '').replace(/[^\]]*$/, ''));
const total = $('Склеить отзывы').first().json.total;
const by = {};
for (const a of arr) { by[a.theme] = by[a.theme] || { всего: 0, негатив: 0, позитив: 0 }; by[a.theme].всего++; if (a.sentiment === 'негатив') by[a.theme].негатив++; if (a.sentiment === 'позитив') by[a.theme].позитив++; }
const table = Object.entries(by).sort((x, y) => y[1].негатив - x[1].негатив).map(([t, v]) => t + ': всего ' + v.всего + ', негатив ' + v.негатив + ', позитив ' + v.позитив).join('\n');
return [{ json: { table, labeled: arr.length, total } }];
На выходе три поля: table (таблица текстом), labeled (сколько отзывов модель разметила) и total (сколько их было в файле). Если labeled меньше total, модель часть отзывов пропустила.
Узел 6. «Разбор для управляющего»
Второй Basic LLM Chain получает только готовые цифры. Системное сообщение:
Ты аналитик кофейни. По таблице тем и тональностей отзывов (цифры уже посчитаны, не меняй их) напиши разбор для управляющего, простым текстом, не длиннее 10 строк:
1) что хвалят; 2) три главные проблемы по числу негативных отзывов и что конкретно сделать с каждой; 3) одна метрика, по которой через месяц проверить улучшение. Не выдумывай отзывов и цифр.
Сообщение пользователя:
{{ "Отзывов: " + $json.total + ", размечено: " + $json.labeled + "\n" + $json.table }}Слова «цифры уже посчитаны, не меняй их» и «не выдумывай отзывов и цифр» стоят здесь не зря, но, как покажет прогон, полностью от выдумок они не спасают.
Что показал прогон
Первый прогон, без правила тональности. Код насчитал: скорость обслуживания 5 негативных отзывов, персонал 3, выпечка 3; вкус кофе 7 позитивных. В разборе для управляющего нашлось три ошибки:
- смягчение негатива: жалобы на вай-фай и цены не получили ни одной негативной пометки, хотя в файле они есть. Код посчитал честно, но посчитал уже смягчённые пометки;
- выдуманная причина: жалобы на выпечку разбор объяснил «свежестью», а гости писали, что выпечка к вечеру заканчивается;
- markdown-звёздочки (знаки разметки, которые в Telegram и в письме видны как лишние символы).
Два прогона с правилом тональности на тех же 50 отзывах. Устойчиво в обоих вышло: скорость обслуживания 10 негативных, розетки и вай-фай 5, цены 5, интерьер и шум 4, выпечка 3. Две темы гуляли: персонал 5 в одном запуске и 3 в другом, вкус кофе 0 и 2. Причина в одном отзыве, который в файле стоит дважды: «Кофе был холодный, переделывать отказались». Это жалоба и на кофе, и на персонал, и модель выбирала то одно, то другое. В первом из двух запусков размечено 50 из 50, и разметка совпала с ручной.
Разбор для управляющего и с правилом снова поставил звёздочки и выдумал совет «отремонтировать неработающие розетки». Гости жаловались на другое: розеток у окна нет. Слова «простым текстом» в промпте звёздочки не удерживают, их надёжнее снимать кодом. Поставьте после «Разбора для управляющего» короткий узел Code:
// Снять звёздочки и решётки из разбора
return $input.all().map(i => ({ json: { text: String(i.json.text || '').replace(/[*#]/g, '') } }));
В прогоне курса этот узел не запускали. Он только удаляет знаки*и#из текста. Выдумку вроде «неработающих розеток» код не поймает: слово «розетки» в отзывах есть, неверен смысл. Её ловит человек, который читает разбор рядом с отзывами.
Отсюда правило урока: считает код, но считает он ровно то, что разметила модель. Перед тем как верить таблице, откройте вывод «Разметить отзывы» и прочитайте 5–10 пометок рядом с самими отзывами.
Доработка, в прогоне курса не проверяли: выдуманную причину вроде «свежести» можно ловить, если требовать от модели к каждой проблеме цитату из отзыва. Для этого второй модели нужны сами тексты негативных отзывов, а сейчас она получает только таблицу. Попробуйте добавить их в сообщение пользователя и дописать в системное сообщение: «к каждой проблеме приведи дословную цитату одного отзыва». Цитату легко проверить глазами по файлу.
Если не получилось
- После Submit ничего не происходит. Сценарий перестал ждать форму: снова нажмите Execute workflow в редакторе и отправьте файл ещё раз.
- «Прочитать CSV» не находит файл. Проверьте, что подпись поля в форме латиницей (
reviews_csv) и что то же имя указано в узле чтения. - В списке отзывов «undefined». Скорее всего, в узле чтения стоит разделитель «,» и столбцы Оценка и Текст не распознались. Поставьте «;». Если файл свой, проверьте, что заголовки называются ровно Оценка и Текст.
- «Посчитать темы» падает с ошибкой разбора JSON. Откройте вывод «Разметить отзывы»: модель вернула текст вместо массива. Проверьте, что в системном сообщении осталась строка «Верни только JSON-массив без пояснений».
- Размечено меньше, чем отзывов. Сравните
labeledиtotal. Если модель пропускает отзывы на большом файле, разбейте его на части. - В таблице появились темы не из списка. Модель придумала свою тему. Проверьте, что список тем в промпте написан через запятую и без опечаток, и запустите ещё раз.
Контрольный вопрос. Почему в этом сценарии темы считает узел Code, а модели достаётся только разметка?
Подсказка: Вспомните книгу отзывов: что требует понимания, а что сделает и калькулятор.
На курсе задания проверяются автоматически. Подобрать курс
Контрольный вопрос. Зачем подпись поля с файлом в форме писать латиницей?
Подсказка: Что n8n сделал с русской подписью в прогоне курса?
На курсе задания проверяются автоматически. Подобрать курс
Контрольный вопрос. Что нашли в разборе для управляющего в первом прогоне, без правила тональности? Выберите все верные варианты.
Выберите все верные варианты.
Подсказка: Сравните разбор с тем, что на самом деле писали гости.
На курсе задания проверяются автоматически. Подобрать курс
Задание. МИССИЯ «Книга отзывов». Соберите в n8n сценарий из шести узлов: «Загрузка CSV», «Прочитать CSV», «Склеить отзывы», «Разметить отзывы», «Посчитать темы», «Разбор для управляющего». В промпт разметки впишите правило тональности, в узле модели задайте Timeout и Max Retries. Запустите его на учебном файле otzyvy.csv, а если есть свои отзывы, то ещё раз на них (в формате Дата;Площадка;Оценка;Текст, без имён гостей). Приложите: (1) оба системных сообщения; (2) вывод узла «Посчитать темы» (поля table, labeled, total); (3) текст разбора для управляющего; (4) две-три фразы: совпадают ли три проблемы в разборе с тремя верхними строками таблицы, нет ли в разборе причин или советов, которых нет в отзывах, и если ваши цифры отличаются от прогона, какой отзыв модель разметила иначе. Принято, если: в сценарии все шесть узлов, подпись поля формы латиницей, разделитель «;»; модель в узле «Разметить отзывы» только размечает, а считает узел Code; в промпте разметки есть правило тональности; labeled равно total; цифры в разборе совпадают с таблицей; для учебного файла больше всего негатива у скорости обслуживания, а среди тем с негативом есть розетки и вай-фай, цены, интерьер и шум, выпечка (числа могут отличаться от прогона на один-два отзыва, расхождение объяснено в пункте 4); в разборе нет markdown-звёздочек; персональные данные гостей не указаны.
Подсказка: Если цифры у вас вышли другими, сначала откройте вывод «Разметить отзывы» и найдите отзыв, которому модель поставила не ту тему. Опишите его в пункте (4), это тоже результат.
✅ Готово, если: программа запускается без ошибок и выводит то, что просят в задании.
На курсе задания проверяются автоматически. Подобрать курс
Что дальше
Отзывы приходят в одном формате, рекламные выгрузки в другом. В следующем уроке соберём недельный отчёт по Яндекс Директу и Метрике: две выгрузки, цифры недели кодом и короткий вывод модели, где разница в одну конверсию не выдаётся за падение.
Итог:
• файл с отзывами принимает форма n8n, подпись поля латиницей, CSV читается с разделителем «;»;
• модель размечает каждый отзыв: тональность и одна тема из закрытого списка, жалоба всегда «негатив»;
• темы и тональности считает узел Code, но считает он ровно то, что разметила модель, поэтому разметку проверяйте глазами по 5–10 отзывам;
• вторая модель пишет разбор по готовой таблице, звёздочки из него снимает код, а выдуманные причины ловите вы;
• на учебном файле с правилом тональности больше всего негатива у скорости обслуживания (10 в обоих прогонах).